راهنمای جامع مقابله با ناترازی دادهها در ML

وقتی دادهها به داد مدل نمیرسند!
در دنیای واقعی، دادهها به ندرت متوازن هستند. این یعنی در یک مجموعهداده، تعداد نمونههای یک کلاس (کلاس اکثریت) بهمراتب بیشتر از کلاس دیگر (کلاس اقلیت) است. به این وضعیت ناترازی دادهها (Imbalanced Data) میگوییم.
چالش اصلی اینجاست که مدلهای یادگیری ماشین، ذاتاً به دنبال بیشینهکردن Accuracy هستند. در دادههای نامتوازن، یک مدل میتواند با پیشبینی همیشگی کلاس اکثریت، به دقت ۹۹٪ نیز برسد، اما در عمل برای شناسایی کلاس اقلیت ـ که معمولاً مهمترین کلاس است ـ کاملاً ناکارآمد باشد. به همین دلیل، در این مسائل Accuracy معیار مناسبی نیست و باید از سنجههای دقیقتر استفاده کنیم.
چرا ناترازی دادهها یک مسئلهی چندلایه است؟
ناترازی فقط یک مشکل آماری ساده نیست، بلکه مستقیماً روی یادگیری مدل اثر میگذارد:
- تمایل مدل به کلاس اکثریت: چون سهم این کلاس در خطای کلی بیشتر است، مدل ناخودآگاه به سمت آن متمایل میشود.
- مرزهای تصمیمگیری ضعیف: تعداد کم نمونههای اقلیت باعث میشود مدل مرز واقعی بین کلاسها را خوب یاد نگیرد.
- حساسیت بالا به نویز و دادههای پرت: در کلاس اقلیت، حتی چند نمونهی نویزی میتوانند یادگیری را منحرف کنند.
- ارزیابی گمراهکننده: اگر فقط Accuracy را ببینیم، ممکن است یک مدل ضعیف را خوب تصور کنیم.
پس بهجای Accuracy از چه معیارهایی استفاده کنیم؟
- Precision: از بین نمونههایی که مدل مثبت پیشبینی کرده، چند مورد واقعاً مثبت بودهاند؟
- Recall (Sensitivity): از بین همهی نمونههای واقعاً مثبت، چند مورد توسط مدل شناسایی شدهاند؟
- F1-Score: میانگین هارمونیک Precision و Recall
- AUC-ROC: توان مدل در تفکیک کلاسها در آستانههای مختلف
- PR-AUC: در دادههای بسیار نامتوازن، معمولاً از ROC-AUC مفیدتر است
- Balanced Accuracy: میانگین دقت روی هر کلاس، بدون غلبهی کلاس اکثریت
برای اطلاع بیشتر متریک های ارزیابی در مساله کلاس بندی را مطالعه کنید.
دستهبندی جامع روشهای مقابله با ناترازی دادهها
بهطور کلی این روشها در سه دسته قرار میگیرند:
بخش اول: روشهای مبتنی بر داده
هدف روشهای مبتنی بر داده (Data-Level Methods) تغییر توزیع داده برای نزدیکشدن به تعادل است.
۱) روشهای نمونهبرداری تصادفی
الف) Random Oversampling
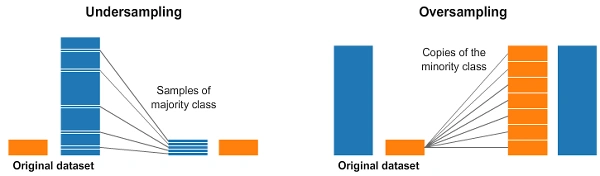
در این روش، نمونههای کلاس اقلیت بهصورت تصادفی تکرار میشوند تا تعدادشان بیشتر شود.
- مزایا: ساده، سریع، قابلفهم
- معایب: خطر Overfitting چون فقط دادههای تکراری وارد مدل میشوند
ب) Random Undersampling
در این روش، بخشی از نمونههای کلاس اکثریت حذف میشوند تا توزیع متعادلتر شود.
- مزایا: کاهش حجم داده و سرعت بیشتر آموزش
- معایب: امکان از دست رفتن اطلاعات مهم
۲) روشهای تولید دادهی مصنوعی
این روشها بهجای کپیکردن، دادههای جدید و مصنوعی (Synthetic Sampling) بر اساس توزیع دادههای موجود میسازند.
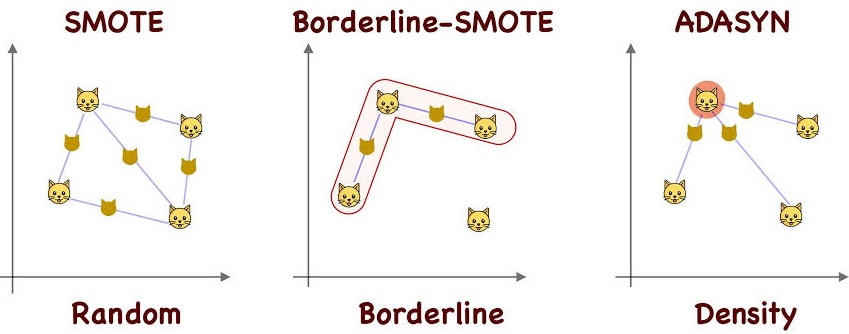
الف) SMOTE
در SMOTE بهجای کپیکردن نمونههای اقلیت، نمونههای جدید مصنوعی بین یک نمونه و k همسایههای نزدیکش ساخته میشود.
که در آن:
- : یک نمونه از کلاس اقلیت
- : یکی از همسایههای نزدیک همان نمونه
- : عدد تصادفی
- مزایا: تنوع بیشتر نسبت به Oversampling ساده، کاهش بیشبرازش
- معایب: ممکن است در نواحی همپوشان بین کلاسها، نویز ایجاد کند
ب) Borderline-SMOTE
در این روش فقط برای نمونههای مرزیِ کلاس اقلیت داده تولید میشود؛ یعنی همان نقاطی که بیشترین احتمال اشتباه مدل در آنها وجود دارد.
- مزایا: تمرکز روی سختترین نقاط مسئله
- معایب: اگر دادههای مرزی نویزی باشند، نتیجه بدتر میشود
ج) ADASYN
یک روش تطبیقی! بهجای تولید یکنواخت، به نمونههای اقلیتی که یادگیری آنها سختتر است، وزن بیشتری میدهد. در روش (Adaptive Synthetic Sampling) معیار سختی، نسبت تعداد همسایگان اکثریت به کل همسایگان است. هرچه این نسبت بیشتر باشد، آن نمونه سختتر است و دادهی مصنوعی بیشتری حول آن تولید میشود.
- مزایا: تمرکز تطبیقی روی نمونههای دشوار
- معایب: حساسیت بالا به Outlierها
۳) روشهای ترکیبی: تولید + پاکسازی
الف) SMOTE + Tomek Links
ابتدا SMOTE دادهی مصنوعی تولید میکند، سپس Tomek Links حذف میشوند. Tomek Link به دو نمونه از دو کلاس مختلف گفته میشود که نزدیکترین همسایهی یکدیگر باشند. وجود چنین جفتی معمولاً نشاندهندهی مرز مبهم بین کلاسهاست.
- مزایا: هم تعادل ایجاد میشود، هم مرزها تمیزتر میشوند
- معایب: ممکن است برخی نمونههای مرزی مفید حذف شوند
ب) SMOTE + ENN
در این روش، ابتدا دادههای مصنوعی با SMOTE تولید میشوند و سپس با استفاده از Edited Nearest Neighbors (ENN) نمونههایی حذف میشوند که با اکثریت همسایگان خود همخوانی ندارند.
- مزایا: پاکسازی قویتر نسبت به Tomek Links
- معایب: ممکن است تهاجمی عمل کند و دادههای مفید را هم حذف کند
۴) روشهای افزونسازی داده
روش تقویت داده (Data Augmentation) بهجای تولید داده در فضای ویژگی، با اعمال تغییرات معنادار روی نمونههای موجود، دادههای جدید تولید میکند؛ بهشرطی که این تغییرات، برچسب کلاس را تغییر ندهند. این رویکرد بیشتر در دادههای غیرساختاریافته کاربرد دارد.
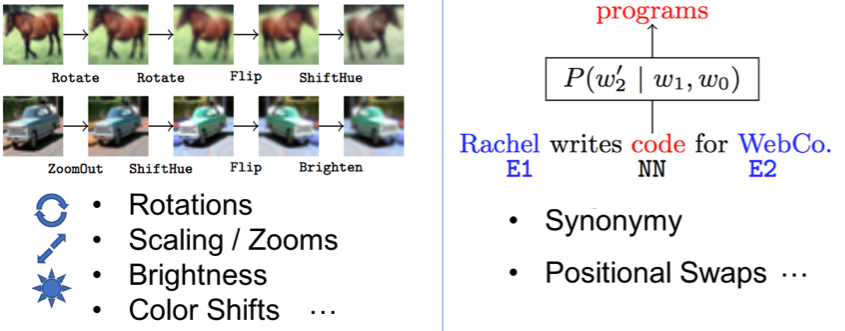
- دادههای تصویری: چرخش، برش، تغییر روشنایی، تغییر کنتراست، حذف تصادفی بخشی از تصویر
- دادههای متنی: جایگزینی مترادف، بازترجمه، حذف یا جابهجایی محدود کلمات
- دادههای صوتی: افزودن نویز، تغییر سرعت، تغییر زیر و بمی
- مزایا: افزایش تنوع داده، کاهش بیشبرازش، بهبود تعمیمپذیری مدل
- معایب: نیازمند دانش دامنه است؛ اگر تبدیلها درست انتخاب نشوند، ممکن است معنای داده یا برچسب آن تغییر کند
۵) روشهای مولد عمیق
این روشها از مدلهای یادگیری عمیق (Deep Generative Models) برای یادگیری توزیع داده و تولید نمونههای مصنوعی واقعگرایانه استفاده میکنند و معمولاً در مسائل پیچیده و دادههای غیرساختاریافته کاربرد دارند.
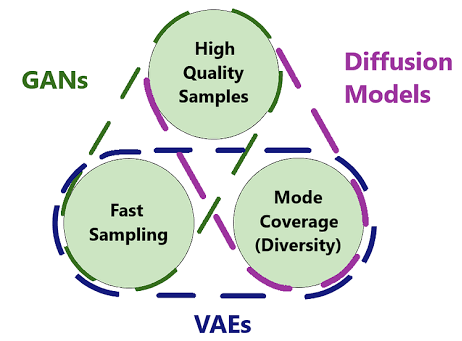
- GAN: تولید داده با استفاده از رقابت بین شبکهی مولد و تشخیصدهنده
- VAE: یادگیری نمایش نهفته و تولید نمونههای جدید از فضای نهفته
- Diffusion Models: تولید داده با فرایند تدریجی حذف نویز از نمونههای نویزی
- مزایا: تولید دادههای پیچیده و باکیفیت، مناسب برای تصویر، صوت و متن
- معایب: هزینهی محاسباتی بالا، نیاز به دادهی اولیهی کافی، آموزش دشوار و تنظیم حساس
بخش دوم: روشهای مبتنی بر الگوریتم
در این دسته روشهای مبتنی بر الگوریتم (Algorithm-Level Methods)، بهجای تغییر داده، خود الگوریتم یا تابع هزینه را تغییر میدهیم.
۱) یادگیری حساس به هزینه
در یادگیری حساس به هزینه (Cost-Sensitive Learning)، خطای مربوط به کلاس اقلیت جریمهی بیشتری میگیرد.یعنی اگر مدل یک نمونهی اقلیت را اشتباه طبقهبندی کند، هزینهی بیشتری نسبت به اشتباه روی کلاس اکثریت پرداخت میکند. اگر تابع هزینهی استاندارد را (L) در نظر بگیریم، نسخهی وزندار آن بهصورت زیر است::
که در آن:
- : وزن کلاس نمونهی i
- : خطای پیشبینی آن نمونه
- مزایا: بدون دستکاری داده، مستقیماً روی هدف یادگیری اثر میگذارد
- معایب: تنظیم وزنها همیشه ساده نیست
۲) استفاده از وزن کلاسها در مدلها
بسیاری از الگوریتمها مثل Logistic Regression، SVM، Random Forest، XGBoost و LightGBM امکان تعیین class weight دارند.یک انتخاب رایج برای وزن کلاسها:
که در آن:
- (N): تعداد کل نمونهها
- (K): تعداد کلاسها
- (Nc): تعداد نمونههای کلاس (c)
در این حالت هر چه تعداد نمونه ها کمتر باشد وزن بیشتری به داده ها اختصاص می یابد.
۳) Focal Loss
این تابع هزینه برای تمرکز روی نمونههای سخت طراحی شده و بهویژه در مسائل نامتوازن بسیار مفید است.
که در آن:
- : ضریب تمرکز روی نمونههای سخت
- : احتمال پیشبینی صحیح
- : وزن کلاس
مزایا: کاهش اثر نمونههای آسان و تمرکز بر موارد دشوار
معایب: نیازمند تنظیم دقیق پارامترها
۴) Ensembleهای مخصوص دادههای نامتوازن
برخی الگوریتمها با تنظیم وزن کلاسها یا بهدلیل ساختار داخلی خود، بهتر با دادههای نامتوازن سازگار میشوند. برای مثال، درختهای تصمیمگیری با استفاده از معیارهایی مانند جینی و آنتروپی که به توزیع کلاسها حساس هستند، میتوانند تا حدی اثر ناترازی را مدیریت کنند. همچنین جنگل تصادفی با تنظیم پارامتر class_weight ، وزن بیشتری به کلاس اقلیت اختصاص میدهد. در مدلهایی مانند XGBoost و LightGBM نیز با استفاده از پارامتر scale_pos_weight میتوان اهمیت کلاس اقلیت را افزایش داد تا مدل توجه بیشتری به آن داشته باشد.
علاوه بر این، روشهای یادگیری مبتنی بر مجموعه (Ensemble Learning) نیز از مهمترین راهکارهای مقابله با ناترازی دادهها هستند. ترکیب چندین مدل ضعیف برای ساخت یک مدل قوی از جمله تکنیک های یادگیری گروهی است که برای دادههای نامتوازن عملکرد خوبی دارند من جمله:
- Balanced Random Forest
- EasyEnsemble
- RUSBoost
- Balanced Bagging
این روشها معمولاً با ترکیب چند زیرمجموعهی متعادل، عملکرد پایدارتری ارائه میدهند.
برای یادگیری بیشتر یادگیری ترکیبی Ensemble Learning مطالعه شود.
نکتهی طلایی و حیاتی:
هرگز، تحت هیچ شرایطی، قبل از تقسیم دادهها به مجموعههای آموزش (Train) و تست (Test)، اقدام به متعادلسازی نکنید!
اگر دادههای تست را نیز متعادل کنید، دیگر نمیتوانید عملکرد واقعی مدل را روی دادههای دنیای واقعی بسنجید، زیرا دادههای تست مصنوعی شدهاند. ترتیب صحیح به شرح زیر است:
- در دادههای نامتوازن، باید از Stratified Train/Test Split و Stratified Cross Validation استفاده کرد تا نسبت کلاسها در همهی بخشها ترین و تست حفظ شود.
- روش متعادلسازی (مثلاً SMOTE) را فقط و فقط روی مجموعهی Train اعمال کنید
- مدل را روی مجموعهی Train متعادلشده آموزش دهید.
- مدل را روی مجموعهی Test اصلی و دستنخورده ارزیابی کنید.
- انتخاب متریک ارزیابی مناسب با توجه به تکنیک های آستانه گذاری بهینه در مسائل نامتوازن
کدام روش را چه زمانی انتخاب کنیم؟
انتخاب روش مناسب برای مقابله با ناترازی داده به عواملی مانند شدت ناترازی، حجم داده، میزان نویز و نوع داده بستگی دارد.
اگر ناترازی کم باشد، معمولاً روشهایی مانند SMOTE یا ADASYN کافی هستند. در ناترازی متوسط، استفاده از روشهای ترکیبی مانند SMOTE همراه با Tomek Links یا ENN و نیز روشهای هزینهمحور مناسبتر است. اما در ناترازی شدید، بهتر است از روشهای ترکیبی پیشرفته، الگوریتمهای مبتنی بر مجموعه یا در مسائل پیچیدهتر از مدلهای مولد استفاده شود.
از نظر حجم داده، وقتی تعداد نمونهها کم است، Undersampling میتواند باعث از دست رفتن اطلاعات مهم شود؛ بنابراین Oversampling یا Data Augmentation انتخاب بهتری است. در مقابل، برای دادههای حجیم میتوان از Undersampling هوشمند یا روشهای ترکیبی استفاده کرد.
در صورت وجود نویز بالا، روشهای پالایشی مانند SMOTE-ENN یا SMOTE-Tomek مناسبتر هستند، زیرا علاوه بر متعادلسازی، دادههای نویزی یا مرزی نامناسب را نیز حذف میکنند. اگر نویز کم باشد، استفاده از SMOTE ساده معمولاً کافی است.
همچنین نوع و پیچیدگی داده نقش مهمی دارد. برای دادههای ساده و کمبعد، روشهایی مانند SMOTE و مشتقات آن مناسباند؛ اما برای دادههای پیچیده و غیرساختاریافته مانند تصویر، صوت و متن، استفاده از Data Augmentation یا مدلهای مولد عمیق گزینهی مناسبتری است. جدول زیر مقایسه ای از روش های بیان شده است.
| روش | ایده اصلی | بهترین کاربرد | مزایا | محدودیتها |
|---|---|---|---|---|
| Random Oversampling | کپی تصادفی | شروع کار و تست سریع | بسیار ساده | بیشبرازش شدید |
| SMOTE | درونیابی بین همسایگان | دادههای با ابعاد متوسط و کمنویز | استاندارد و مؤثر | تولید نویز در نواحی درهم |
| Borderline-SMOTE | تولید داده در نواحی مرزی | دادههایی با مرز مشخص اما مبهم | بهبود نقاط دشوار | حساس به نویز مرزی |
| ADASYN | تولید تطبیقی بر اساس سختی نمونهها | دادههایی با توزیع پیچیده | بسیار هوشمند و متمرکز | تقویت پرتها (Outliers) |
| SMOTE-Tomek | تولید + حذف جفتهای مبهم | دادههایی با نویز کم | شفافسازی مرز کلاسها | زمانبرتر و حذف احتمالی دادههای مفید |
| SMOTE-ENN | تولید + پالایش قوی | دادههای با نویز بالا | پاکسازی عمیق | حذف زیاد داده در دیتاستهای کوچک |
| Data Augmentation | تغییر فیزیکی و معنادار داده | دادههای تصویری، صوتی، متنی | تنوع بینظیر و کاهش بیشبرازش | نیاز به دانش دامنه، خطر تغییر برچسب |
| GAN / VAE / Diffusion | یادگیری توزیع و تولید از صفر | دادههای پیچیده و با ابعاد بالا (تصویر، متن) | تولید دادههای بسیار واقعی | نیاز به دادهی زیاد، هزینهی محاسباتی بالا |
جمعبندی
ناترازی دادهها یکی از چالشهای مهم در یادگیری ماشین است که باعث میشود مدل به کلاس پرتعداد متمایل شود و در تشخیص کلاس کمتعداد، که معمولاً مهمتر است، ضعیف عمل کند. در این شرایط، معیارهایی مثل Recall، F1-Score و PR-AUC از Accuracy مهمتر هستند. برای حل این مشکل میتوان از روشهای مبتنی بر داده مثل Oversampling و SMOTE، روشهای الگوریتمی مثل Class Weight و Focal Loss، و روشهای ترکیبی Ensemble استفاده کرد. همچنین ارزیابی درست مدل فقط زمانی معتبر است که متعادلسازی صرفاً روی دادههای آموزش انجام شود.