یادگیری فدرال


یادگیری فدرال چیست؟
یادگیری فدرال یا Federated Learning (FL) یک پارادایم نوین در یادگیری ماشین است که در آن چندین سازمان، مرکز یا دستگاه میتوانند بهصورت مشترک یک مدل را آموزش دهند، بدون آنکه دادههای خام خود را با یک سرور مرکزی یا با یکدیگر به اشتراک بگذارند. در این روش، برخلاف یادگیری متمرکز که همه دادهها در یک محل جمعآوری میشوند، دادهها در محل خود باقی میمانند و این مدل است که به سمت دادهها میرود، نه داده به سمت مدل.
فهرست متن
این رویکرد در پاسخ به دو نیاز مهم شکل گرفته است: نخست، حفظ حریم خصوصی و رعایت مقرراتی مانند GDPR و HIPAA، و دوم، رفع محدودیتهای عملی در انتقال حجم عظیم داده از دستگاهها یا مراکز مختلف مانند گوشیهای هوشمند، حسگرهای صنعتی و بیمارستانها. به همین دلیل، یادگیری فدرال بهعنوان یک راهکار مهم برای استفاده از دادههای توزیعشده و حساس شناخته میشود.
نحوه کار یادگیری فدرال
معماری استاندارد یادگیری فدرال معمولاً از نوع مشتری-سرور (client-server) است و در قالب چرخههایی تکرارشونده انجام میشود. در هر چرخه، ابتدا سرور مرکزی یک مدل اولیه یا نسخه فعلی مدل سراسری را برای تعدادی از کلاینتها ارسال میکند. این کلاینتها میتوانند بیمارستانها، گوشیهای موبایل، سازمانها یا هر گرهای باشند که داده محلی در اختیار دارد.
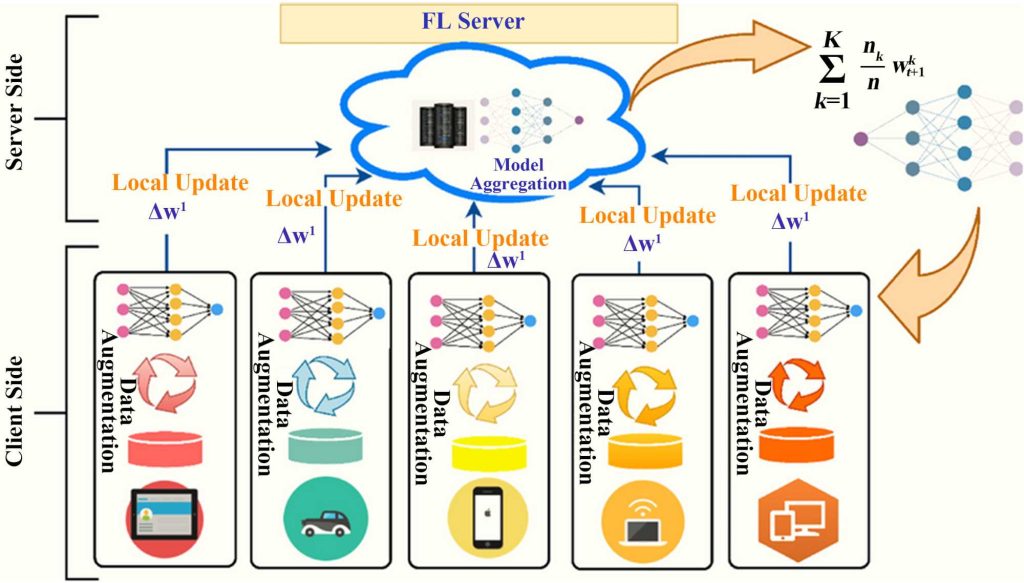
سپس هر کلاینت مدل دریافتی را تنها با استفاده از دادههای محلی خود آموزش میدهد. این دادهها هرگز از محل ذخیرهسازی خود خارج نمیشوند و فقط آموزش بهصورت محلی انجام میشود. پس از اتمام آموزش محلی، کلاینت بهجای ارسال داده خام، فقط وزنهای بهروزشده مدل یا گرادیانهای حاصل از آموزش را برای سرور بازمیگرداند. سرور مرکزی این بهروزرسانیها را از کلاینتهای مختلف جمعآوری کرده و با یک روش تجمیع مناسب آنها را ترکیب میکند. حاصل این مرحله، یک مدل سراسری جدید است که دوباره برای کلاینتها ارسال میشود و این چرخه تا رسیدن مدل به همگرایی یا تعداد دور مشخصی ادامه پیدا میکند.
بهصورت خلاصه، روند کار شامل این مراحل است:
- ارسال مدل اولیه از سرور به کلاینتها
- آموزش محلی مدل روی دادههای هر کلاینت
- بازگرداندن پارامترها یا گرادیانها به سرور
- تجمیع بهروزرسانیها در سرور
- ساخت مدل سراسری جدید و تکرار فرآیند
تفاوت با یادگیری متمرکز
در یادگیری متمرکز (Centralized Learning)، همه دادهها از منابع مختلف جمعآوری شده و در یک مخزن یا سرور مرکزی ذخیره میشوند. سپس مدل روی کل دادهها بهصورت یکجا آموزش میبیند. این روش معمولاً از نظر کنترل، نظارت و سادگی پیادهسازی مزیت دارد، اما در حوزههایی که دادهها حساساند یا از نظر قانونی امکان انتقال آنها وجود ندارد، با محدودیت جدی مواجه میشود.
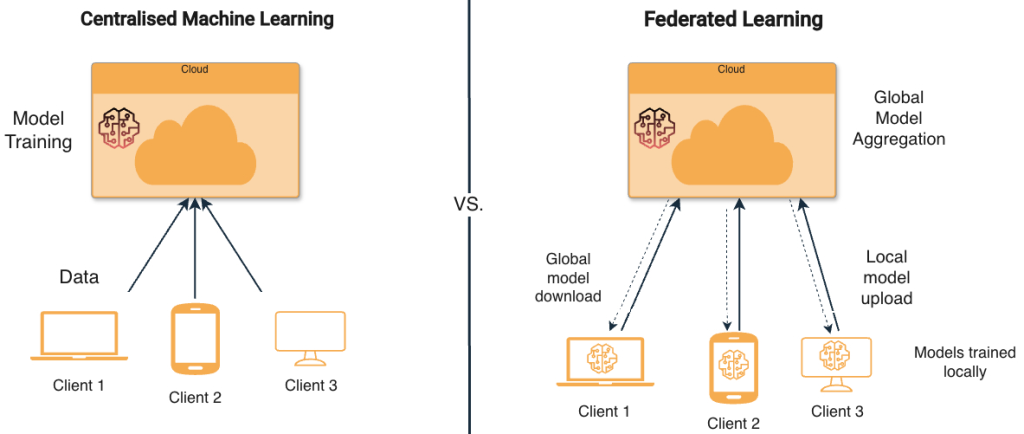
در مقابل، در یادگیری فدرال داده خام هرگز مرکز خود را ترک نمیکند. بهجای انتقال دادهها، فقط دانش حاصل از آموزش محلی در قالب پارامترها یا گرادیانها منتقل میشود. بنابراین تفاوت اصلی این دو رویکرد را میتوان در یک جمله خلاصه کرد: در یادگیری متمرکز، دادهها به سمت مدل میروند؛ اما در یادگیری فدرال، مدل به سمت دادهها میرود.
معرفی FedAvg
پایهایترین و پرکاربردترین الگوریتم در یادگیری فدرال، Federated Averaging یا FedAvg است که در سال 2017 توسط McMahan و همکاران معرفی شد. در این روش، هر کلاینت پس از دریافت مدل سراسری، آن را روی دادههای محلی خود برای چند epoch آموزش میدهد و سپس وزنهای جدید مدل را به سرور میفرستد. سرور نیز این وزنها را با میانگینگیری وزنی ترکیب میکند. فرمول کلی FedAvg بهشکل زیر است:
که در آن:
- وزن مدل کلاینت پس از آموزش محلی است
- تعداد نمونههای موجود در کلاینت است
- مجموع کل نمونههای شرکتکننده در آن round است
بنابراین، در FedAvg مدلهایی که روی داده بیشتر آموزش دیدهاند سهم بیشتری در مدل نهایی دارند. این روش ساده، مؤثر و استاندارد پایه در بسیاری از پیادهسازیهای FL است.
شرط مهم در تجمیع مدلها
برای آنکه وزنهای مدلهای محلی قابل تجمیع باشند، باید معماری مدل در همه کلاینتها یکسان باشد. بهعبارت دیگر:
- تعداد لایهها باید یکسان باشد
- ترتیب پارامترها باید متناظر باشد
- شکل (
shape) وزنها باید با هم سازگار باشد
بنابراین نمیتوان دو مدل با معماری متفاوت را مستقیماً با FedAvg تجمیع کرد. اگرچه دادههای محلی میتوانند از نظر محتوا، کیفیت یا توزیع با هم متفاوت باشند، اما ساختار مدل باید ثابت بماند.
انواع یادگیری فدرال
یادگیری فدرال بسته به نوع توزیع داده و ساختار کلاینتها به چند دسته تقسیم میشود:
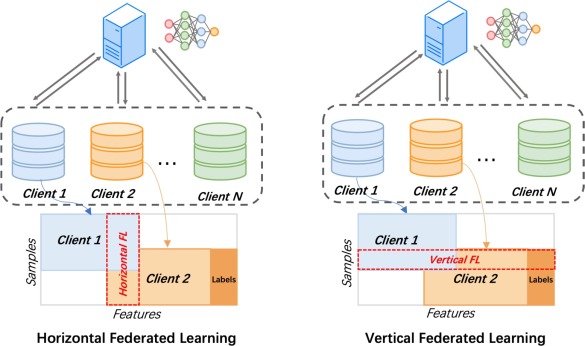
- Horizontal Federated Learning: زمانی که کلاینتها ویژگیهای یکسان دارند اما نمونههای آنها متفاوت است. این سناریو برای بیمارستانهای مختلف با دادههای بیماران متفاوت بسیار رایج است.
- Vertical Federated Learning: زمانی که کلاینتها روی بیماران یا افراد مشترک داده دارند، اما نوع ویژگیها متفاوت است؛ مثلاً یک مرکز ECG دارد و مرکز دیگر نتایج آزمایشگاهی همان افراد را.
- Cross-silo Federated Learning: حالتی که تعداد کلاینتها کم و هر کلاینت یک سازمان بزرگ مثل بیمارستان یا بانک است.
- Cross-device Federated Learning: حالتی که تعداد کلاینتها بسیار زیاد است، مانند میلیونها گوشی موبایل یا دستگاه IoT.
در کاربردهای پزشکی، معمولاً سناریوی Horizontal + Cross-silo مناسبترین حالت است.
مزایا و معایب
مزایا
یادگیری فدرال چند مزیت مهم دارد:
- حفظ حریم خصوصی، زیرا داده خام جابهجا نمیشود
- امکان همکاری بین چند مرکز بدون نیاز به ادغام فیزیکی دادهها
- کاهش ریسک حقوقی و انطباق بهتر با قوانین حریم خصوصی
- امکان استفاده از دادههای بیشتر و متنوعتر برای ساخت مدلهای قویتر
- مناسب برای حوزههای حساس مانند پزشکی، مالی و موبایل
محدودیتها
در کنار مزایا، FL با محدودیتها و پیچیدگیهای مهمی نیز همراه است:
- پیادهسازی و نگهداری آن از یادگیری متمرکز پیچیدهتر است
- هزینه ارتباطی بالایی دارد، چون در هر round باید پارامترهای مدل جابهجا شوند
- در برابر ناهمگونی دادهها بین مراکز حساس است
- آموزش و دیباگ کردن آن دشوارتر است
- ممکن است دقت آن در برخی شرایط از حالت متمرکز کمتر باشد
چالشهای کلیدی
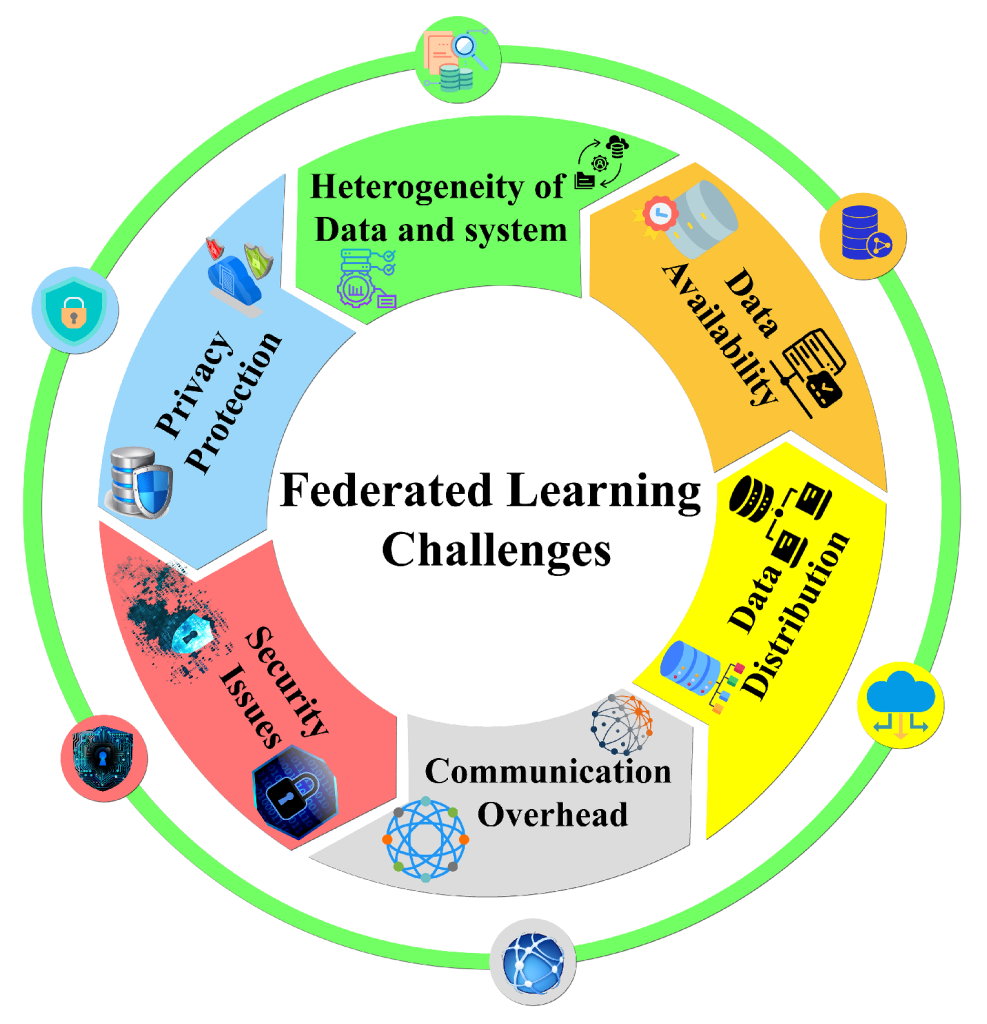
1) ناهمگونی آماری دادهها (Statistical Heterogeneity)
مهمترین چالش FL این است که دادههای کلاینتهای مختلف معمولاً Non-IID هستند؛ یعنی توزیع آماری آنها یکسان نیست. برای مثال، در یک پروژه پزشکی ممکن است یک بیمارستان بیماران کلاس یک بیشتری داشته باشد و بیمارستان دیگر موارد کلاس دو بیشتری ببیند. در چنین حالتی، میانگینگیری ساده همیشه به بهترین نتیجه نمیرسد و ممکن است مدل سراسری روی برخی مراکز ضعیف عمل کند.
2) ناهمگونی سیستمی (System Heterogeneity)
کلاینتها از نظر سختافزار، سرعت پردازش، پهنای باند شبکه و منابع حافظه با یکدیگر تفاوت دارند. برخی کلاینتها ممکن است کندتر باشند و آموزش سراسری را با تأخیر مواجه کنند. این مسئله بهویژه در سناریوهای واقعی با دستگاههای متنوع اهمیت زیادی دارد.
3) هزینههای ارتباطی (Communication Bottleneck)
اگر مدل بزرگ باشد، ارسال وزنها در هر دور میتواند بسیار پرهزینه باشد. این چالش در شبکههای با پهنای باند محدود یا در کاربردهایی که تعداد round زیاد است، بیشتر خود را نشان میدهد.
4) تهدیدات امنیتی و حریم خصوصی
اگرچه داده خام منتقل نمیشود، اما FL بهطور کامل از حملات مصون نیست. برای مثال:
- در حملات
Gradient Inversionممکن است مهاجم بتواند از روی گرادیانها بخشی از داده را بازسازی کند - در حملات
Membership Inferenceممکن است مشخص شود یک نمونه خاص در داده آموزشی وجود داشته یا نه - در حملات
Backdoorیک کلاینت مخرب میتواند مدل سراسری را آلوده کند
برای کاهش این تهدیدها، معمولاً از روشهایی مانند Differential Privacy، Secure Aggregation و گاهی Homomorphic Encryption استفاده میشود.
روشهای پیشرفتهتر:
FedProx
FedProx نسخهای توسعهیافته از FedAvg است که یک قید اضافی به آموزش محلی اضافه میکند تا مدل محلی بیش از حد از مدل سراسری دور نشود. این روش بهخصوص در شرایطی که دادهها بین کلاینتها خیلی ناهمگون هستند، پایداری بیشتری نسبت به FedAvg دارد.
FedBN
FedBN برای سناریوهایی مناسب است که تفاوت کلاینتها بیشتر از جنس domain shift باشد؛ مثلاً تفاوت دستگاه تصویربرداری، تفاوت نویز، کیفیت ثبت یا شرایط محیطی. در این روش، لایههای BatchNorm محلی نگه داشته میشوند و بقیه پارامترها تجمیع میشوند. این کار باعث میشود مدل بهتر با تفاوتهای محلی هر مرکز سازگار شود.
Personalization
در برخی کاربردها، یک مدل کاملاً مشترک برای همه کلاینتها بهترین انتخاب نیست. در این مواقع از Personalization استفاده میشود؛ یعنی بخشی از مدل یا دانش بهصورت سراسری مشترک باقی میماند، اما بخشی دیگر برای هر کلاینت بهصورت اختصاصی تنظیم میشود. این روش در شرایطی که تفاوت مراکز زیاد است، میتواند عملکرد بهتری در سطح هر مرکز ارائه دهد.
کاربردهای واقعی
پزشکی
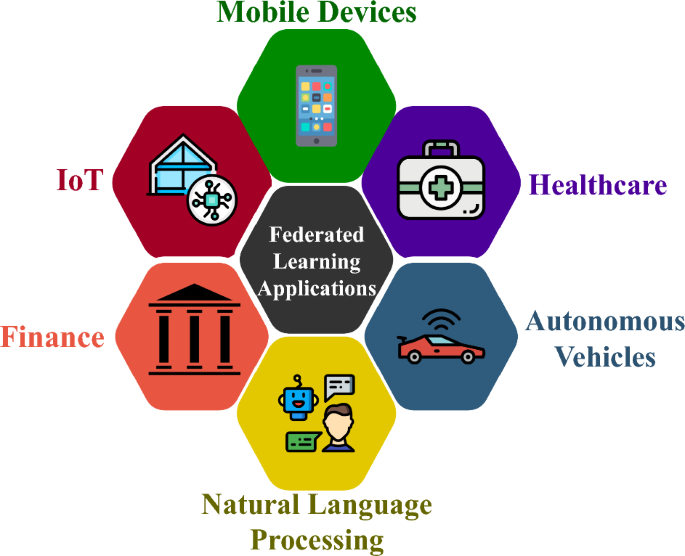
یکی از مهمترین حوزههای استفاده از FL، پزشکی است. بیمارستانها و مراکز درمانی معمولاً به دلیل قوانین حریم خصوصی اجازه اشتراک مستقیم دادههای بیماران را ندارند. با این حال، آنها میتوانند با استفاده از یادگیری فدرال بهصورت مشترک مدلهایی برای سگمنتیشن تصاویر پزشکی، تشخیص بیماری، پیشبینی ریسک بالینی و پردازش پروندههای الکترونیک سلامت آموزش دهند.
موبایل و دستگاههای هوشمند
در گوشیهای هوشمند و دستگاههای پوشیدنی، FL برای کاربردهایی مثل صفحهکلید پیشبینیکننده، شخصیسازی پیشنهادها، تشخیص گفتار و تحلیل فعالیت کاربر بهکار میرود. مزیت اصلی این است که تجربه کاربر بهتر میشود بدون آنکه دادههای خصوصی او بهصورت خام به سرور منتقل شوند.
سیستمهای توصیهگر
فروشگاههای آنلاین، شبکههای اجتماعی و سرویسهای محتوایی میتوانند از یادگیری فدرال برای ساخت سیستمهای توصیهگر شخصیسازیشده استفاده کنند، در حالی که تاریخچه تعامل کاربران بهصورت محلی حفظ میشود.
سیستمهای چندمرکزی و صنعتی
در سازمانهای چندشعبهای، کارخانهها، سامانههای IoT و حتی خودروهای هوشمند، FL این امکان را فراهم میکند که از دادههای توزیعشده برای ساخت یک مدل بهتر استفاده شود، بدون آنکه همه دادهها در یک نقطه متمرکز شوند.
جمعبندی
یادگیری فدرال یک تغییر پارادایم مهم در یادگیری ماشین است که بهجای تمرکز بر جمعآوری داده، بر همکاری توزیعشده و حفظ حریم خصوصی تکیه دارد. در این روش، مدل بهجای داده جابهجا میشود و همین ویژگی آن را برای حوزههایی مانند پزشکی، موبایل و سیستمهای چندمرکزی بسیار ارزشمند میکند. در عین حال، چالشهایی مانند دادههای Non-IID، هزینه ارتباطی، ناهمگونی سیستمی و تهدیدات امنیتی باعث میشوند انتخاب روش مناسب بسیار مهم باشد. FedAvg بهعنوان روش پایه، شروع خوبی است، اما در سناریوهای پیچیدهتر معمولاً روشهایی مانند FedProx، FedBN و Personalization عملکرد بهتری ارائه میدهند.