رگرسیون چندجمله ای و خطی و مثال پایتون


رگرسیون چندجمله ای و خطی در یادگیری ماشین
رگرسیون (Regression) یکی از روشهای مهم در یادگیری ماشین و آمار است که برای بررسی رابطه بین متغیرها و پیشبینی مقادیر عددی استفاده میشود. به بیان ساده، رگرسیون روشی است که کمک میکند بفهمیم یک متغیر چگونه تحت تأثیر یک یا چند متغیر دیگر تغییر میکند و بتوانیم مقدار آن را پیشبینی کنیم.
در یادگیری ماشین، رگرسیون جزء روشهای یادگیری نظارتشده است. در این روش، مدل با استفاده از دادههای گذشته آموزش داده میشود و سپس از آن برای پیشبینی مقادیر جدید استفاده میشود. به همین دلیل رگرسیون در مسائل مختلفی مانند پیشبینی قیمت خانه، میزان فروش، درآمد، دما، مصرف انرژی و بسیاری از مسائل علمی و پزشکی کاربرد دارد.
رگرسیون خطی (Linear Regression)
رگرسیون خطی سادهترین و رایجترین الگوریتم رگرسیون است. این روش فرض میکند که بین متغیرهای مستقل و متغیر وابسته یک رابطه خطی وجود دارد. هدف مدل این است که بهترین خط برازش را پیدا کند؛ یعنی خطی که کمترین اختلاف را با دادههای واقعی داشته باشد.
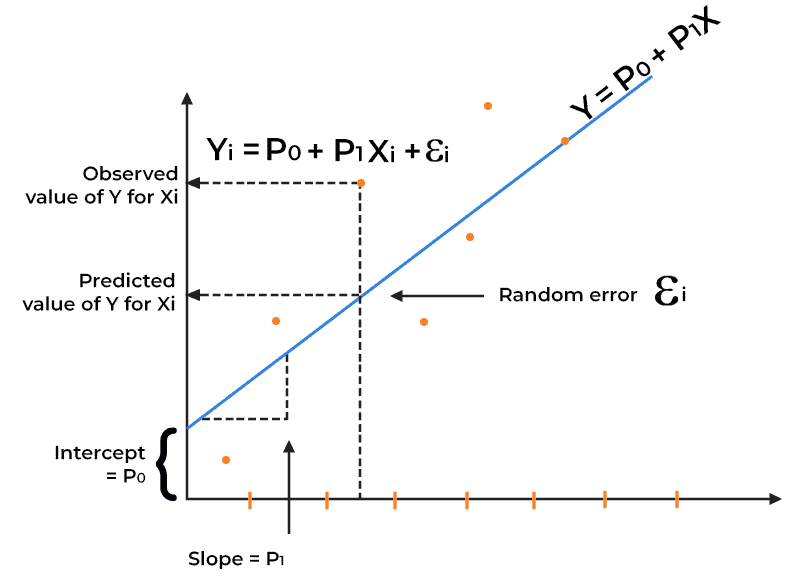
فرمول رگرسیون خطی ساده Simple Linear Regression به صورت زیر است:
در این فرمول، y مقدار متغیر وابسته (خروجی)، x متغیر مستقل (ورودی)، β0 عرض از مبدأ، β1 ضریب شیب خط و ε خطای مدل است. در واقع مدل تلاش میکند ضرایب β را به گونهای تعیین کند که اختلاف بین مقادیر واقعی و مقادیر پیشبینیشده حداقل شود.
اگر چند متغیر ورودی وجود داشته باشد از رگرسیون خطی چندگانه (Multiple Linear Regression) استفاده میشود:
که در آن:
- β0 عرض از مبدأ
- β1,β2,…,βp ضرایب مدل
- x1,x2,…,xp متغیرهای ورودی
ŷi مقدار پیشبینیشده توسط مدل است. رگرسیون خطی در مسائل مختلفی مانند پیشبینی قیمت، تحلیل رابطه بین متغیرها، بررسی روندهای ساده، تحلیل دادههای اقتصادی و محیطزیستی کاربرد فراوان دارد.
رگرسیون غیرخطی چندجملهای (Polynomial Regression)
رگرسیون چندجملهای توسعهای از رگرسیون خطی است که میتواند روابط غیرخطی را نیز مدل کند. در بسیاری از مسائل واقعی، رابطه بین متغیرها به صورت خط مستقیم نیست و رفتارهای پیچیدهتری مشاهده میشود. در این شرایط رگرسیون چندجملهای میتواند مدل مناسبتری ارائه دهد.
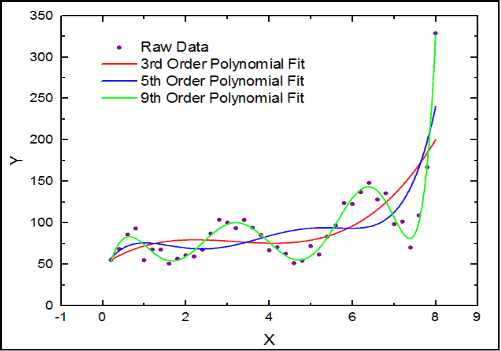
فرمول کلی رگرسیون چندجملهای به صورت زیر است:
در این مدل، توانهای مختلف x به معادله اضافه میشوند تا رفتارهای پیچیدهتر قابل مدلسازی باشند.β1,β2,…,βp ضرایب مدل و β0 عرض از مبدأ مدل می باشد که در فرآیند آموزش مدل به گونهای تنظیم میشوند که بهترین برازش بین دادههای واقعی و پیشبینیشده ایجاد شود.
ای مثال ممکن است یک متغیر ابتدا به آرامی افزایش یابد، سپس رشد سریعتری داشته باشد و در ادامه دوباره روند آن کاهش یابد. چنین الگویی با یک خط مستقیم قابل مدلسازی نیست، اما با یک تابع چندجملهای میتوان آن را به خوبی تقریب زد.این روش در بسیاری از مسائل مهندسی، علوم محیطی، مدلسازی روندهای غیرخطی، تحلیل دادههای تجربی و پیشبینی پدیدههای پیچیده کاربرد دارد.
تابع خطا و معیار برازش مدل
در رگرسیون، هدف اصلی پیدا کردن ضرایب مدل به گونهای است که اختلاف بین مقادیر واقعی و مقادیر پیشبینیشده حداقل شود. یکی از متداولترین معیارهای اندازهگیری خطا مجموع مربعات خطا (Sum of Squared Errors – SSE) است.در رگرسیون خطی و چند جمله ای، که مدل معمولاً سعی میکند مجموع مربعات خطاها را کمینه کند. این معیار به صورت زیر تعریف میشود:
در اینجا yi مقدار واقعی و ŷi مقدار پیشبینیشده توسط مدل است. هرچه این مقدار SSE کمتر باشد، مدل بهتر دادهها را برازش کرده است.با این حال اگر مدل بیش از حد پیچیده شود ممکن است دچار بیشبرازش (Overfitting) شود. در این حالت مدل دادههای آموزشی را بسیار خوب یاد میگیرد اما در پیشبینی دادههای جدید عملکرد ضعیفی خواهد داشت. برای جلوگیری از این مشکل از روشهای منظمسازی (Regularization) استفاده میشود.
انواع الگوریتم های منظم سازی در رگرسیون
منظمسازی تکنیکی است که برای کنترل پیچیدگی مدل و جلوگیری از بیشبرازش استفاده میشود. در این روش یک جمله جریمه به تابع خطا اضافه میشود تا مدل از انتخاب ضرایب بسیار بزرگ جلوگیری کند. سه روش رایج منظمسازی یا Regularization عبارتند از:
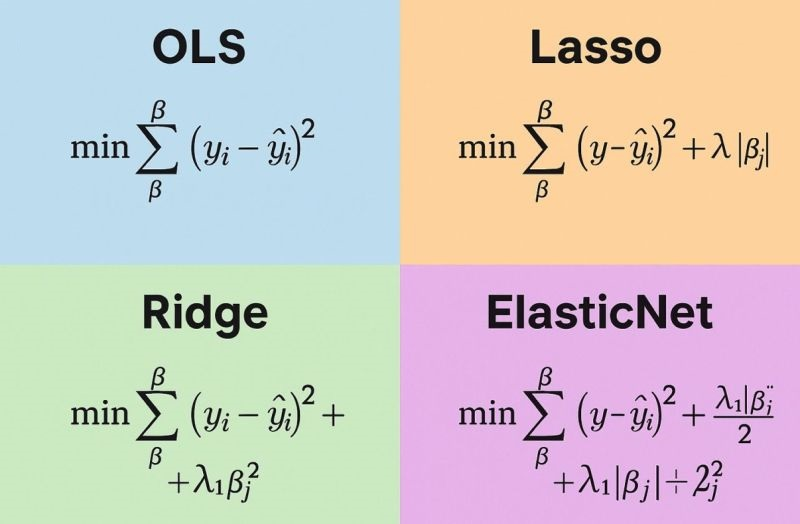
- رگرسیون ریج (Ridge)
- رگرسیون لاسو (Lasso)
- رگرسیون الاستیکنت (Elastic Net)
رگرسیون ریج (Ridge Regression)
رگرسیون ریج زمانی کاربرد دارد که بین متغیرهای مستقل همبستگی بالا (Multicollinearity) وجود داشته باشد. در چنین شرایطی ضرایب رگرسیون خطی ممکن است بسیار ناپایدار شوند و تغییرات کوچک در دادهها باعث تغییرات بزرگ در ضرایب مدل شود.
در رگرسیون ریج یک جمله جریمه از نوع L2 Regularization به تابع خطا اضافه میشود بنابراین تابع هدف در رگرسیون ریج به صورت زیر است:
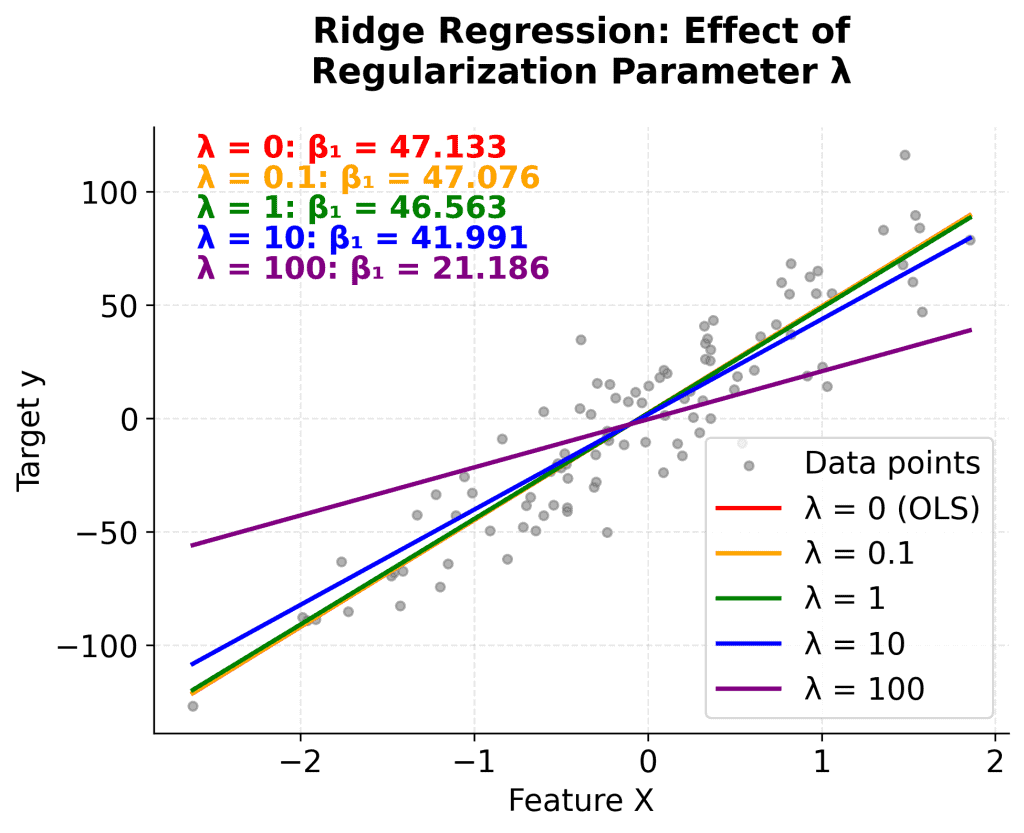
در این رابطه، بخش اول خطای مدل و بخش دوم جریمه مربوط به ضرایب است.
- λ = پارامتر منظمسازی (قدرت جریمه را کنترل میکند؛ λ بزرگتر به معنای منظمسازی قویتر است)
- βj = ضریب ویژگی j (پارامتری که سعی در تخمین آن داریم)
- p = تعداد ویژگیها (به استثنای عرض از مبدا β0)
λ پارامتری است که شدت این جریمه را کنترل میکند. اگر λ بزرگتر شود، ضرایب بیشتر کوچک میشوند و مدل سادهتر میشود. با این حال، در رگرسیون ریج ضرایب معمولاً به صفر کامل نمیرسند، بلکه فقط کوچک میشوند. رگرسیون ریج برای دادههایی با ویژگیهای همبسته، کاهش بیشبرازش و پایدارتر کردن مدل بسیار مناسب است. مزایای رگرسیون ریج:
- کاهش بیشبرازش
- پایدارتر شدن ضرایب مدل
- مناسب برای دادههای دارای همبستگی بالا
رگرسیون لاسو(Lasso Regression)
رگرسیون لاسو نیز نوعی روش منظمسازی است اما در آن از L1 Regularization استفاده میشود. در این روش مجموع قدر مطلق ضرایب به تابع خطا اضافه میشود:
در اینجا نیز λ شدت جریمه را مشخص میکند. هرچه این مقدار بزرگتر باشد، احتمال صفر شدن ضرایب بیشتر میشود.
ویژگی مهم لاسو این است که میتواند برخی ضرایب را دقیقاً برابر صفر کند. در نتیجه مدل به طور خودکار ویژگیهای غیرمهم را حذف میکند. به همین دلیل لاسو علاوه بر جلوگیری از بیشبرازش، به عنوان یک روش انتخاب ویژگی (Feature Selection) نیز شناخته میشود. مزایای رگرسیون لاسو:
- سادهتر شدن مدل
- حذف ویژگیهای غیرضروری
- افزایش قابلیت تفسیر مدل
رگرسیون الاستیکنت ( elastic net )
الاستیکنت ترکیبی از رگرسیون ریج و لاسو است و از هر دو نوع جریمه L1 و L2 استفاده میکند:
در این روش دو پارامتر تنظیمی وجود دارد:
- λ₁ = شدت جریمه L1
- λ₂ = شدت جریمه L2
الاستیکنت زمانی بسیار مفید است که:
- تعداد ویژگیها زیاد باشد
- بین متغیرهای مستقل همبستگی بالا وجود داشته باشد
- بخواهیم هم انتخاب ویژگی انجام شود و هم پایداری ضرایب حفظ شود
این روش در بسیاری از مسائل دادهکاوی، تحلیل دادههای زیستی، اقتصادسنجی و یادگیری ماشین کاربرد گستردهای دارد.
کد پایتون
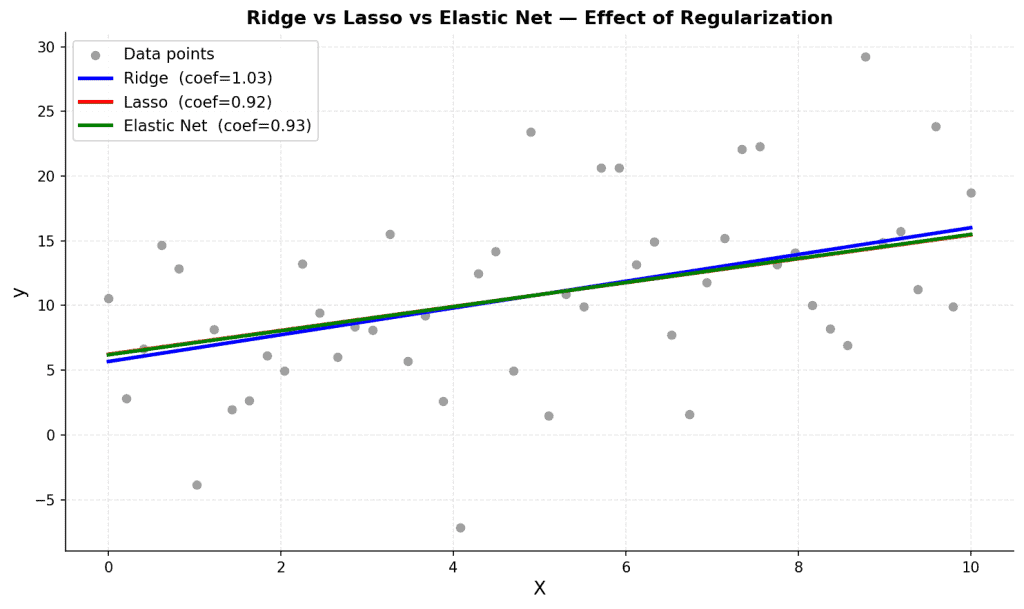
این کد با استفاده از کتابخانه Scikit-Learn، عملکرد سه مدل رگرسیون Ridge، Lasso و Elastic Net را در مواجهه با دادههای دارای نویز بالا مقایسه میکند. در این فرآیند، هر مدل با اعمال جریمههای مخصوص (L1 و L2) روی ضرایب، سعی میکند از بیشبرازش (Overfitting) روی نوسانات تصادفی جلوگیری کرده و روند اصلی دادهها را استخراج کند؛ خروجی نمودار و ضرایب بهدستآمده به خوبی نشان میدهند که چگونه انتخاب نوع منظمسازی و تنظیم پارامتر آلفا میتواند منجر به ایجاد مدلهای پایدارتر، سادهتر و قابلاعتمادتر در تحلیلهای پیشبینانه شود.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import Lasso, Ridge, ElasticNet

np.random.seed(0)
X = np.linspace(0, 10, 50)
y = 2 * X + np.random.normal(0, 6, 50)   # نویز زیاد

X2 = X.reshape(-1, 1)

ridge  = Ridge(alpha=50)
lasso  = Lasso(alpha=2.0)
enet   = ElasticNet(alpha=2.0, l1_ratio=0.5)

ridge.fit(X2, y);  lasso.fit(X2, y);  enet.fit(X2, y)

fig, ax = plt.subplots(figsize=(10, 6))
fig.patch.set_facecolor("white")

ax.scatter(X, y, color="gray", s=30, alpha=0.7,label="Data points")
ax.plot(X,ridge.predict(X2),color="blue",label=f"Ridge(coef={ridge.coef_[0]:.2f})")
ax.plot(X,lasso.predict(X2),color="red",label=f"Lasso(coef={lasso.coef_[0]:.2f})")
ax.plot(X,enet.predict(X2),color="green",label=f"ElasticNet(coef={enet.coef_[0]:.2f})")

ax.set_xlabel("X", fontsize=13)
ax.set_ylabel("y", fontsize=13)
ax.set_title("Ridge vs Lasso vs Elastic Net — Effect of Regularization",
 fontsize=13, fontweight="bold")
ax.legend(fontsize=11)
ax.grid(True, linestyle="--", alpha=0.3)
ax.spines[["top","right"]].set_visible(False)

plt.tight_layout()
خروجی این کد یک نمودار مقایسهای را نشان میدهد که در آن نقاط خاکستری دادههای واقعیِ نویزی هستند و سه خط رنگی، خط برازششده توسط مدلهای Ridge (آبی)، Lasso (قرمز) و Elastic Net (سبز) را نمایش میدهند. این خطوط نشان میدهند که هر روش منظمسازی چگونه با وجود نویز زیاد تلاش میکند روند اصلی دادهها را تخمین بزند؛ در نتیجه میتوان مشاهده کرد که مقدار ضریب خط (coef) در هر مدل متفاوت است و Regularization باعث کوچکتر شدن ضرایب و کاهش اثر نویز میشود، که در نهایت به ساخت مدلی پایدارتر و کمتر مستعد بیشبرازش منجر میگردد.
جمعبندی
رگرسیون یکی از بنیادیترین ابزارهای یادگیری ماشین برای تحلیل دادهها و پیشبینی مقادیر عددی است. رگرسیون خطی برای روابط ساده و خطی مناسب است، در حالی که رگرسیون چندجملهای قادر است روابط غیرخطی را نیز مدلسازی کند. در مسائل واقعی که دادهها پیچیدهتر هستند، استفاده از تکنیکهای منظمسازی مانند ریج، لاسو و الاستیکنت میتواند از بیشبرازش جلوگیری کرده و دقت و پایداری مدل را افزایش دهد. به همین دلیل این روشها در بسیاری از حوزههای علمی، مهندسی و تحلیل داده به عنوان ابزارهای پایهای در مدلسازی و پیشبینی مورد استفاده قرار میگیرند.