دستهبندی الگوریتمهای رگرسیون

رگرسیون چیست؟
رگرسیون یکی از روشهای مهم در آمار و یادگیری ماشین است که برای مدلسازی رابطه بین یک متغیر وابسته و یک یا چند متغیر مستقل استفاده میشود. متغیر وابسته همان مقداری است که قصد داریم آن را پیشبینی کنیم، در حالی که متغیرهای مستقل عواملی هستند که میتوانند بر مقدار خروجی تأثیر بگذارند.
بهطور کلی، رابطه رگرسیونی را میتوان به شکل زیر نمایش داد:
در این رابطه، Y متغیر وابسته، متغیر یا متغیرهای مستقل، تابعی برای بیان رابطه بین ورودی و خروجی، و ε نشاندهنده خطا یا نویز مدل است. هدف اصلی در رگرسیون این است که تابعی پیدا شود که بتواند مقدار خروجی را با کمترین خطا پیشبینی کند.
انواع رگرسیون
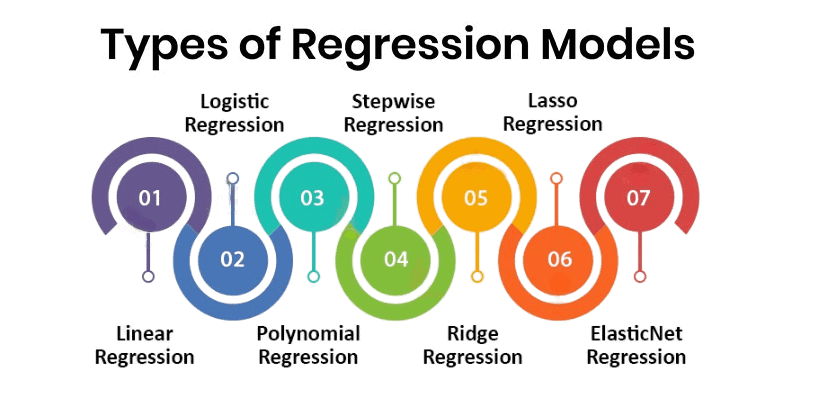
الگوریتمهای رگرسیون را میتوان از دیدگاههای مختلفی دستهبندی کرد. برخی منابع این الگوریتمها را بر اساس شکل رابطه بین ورودی و خروجی، برخی بر اساس نوع تابع هزینه، و برخی دیگر بر اساس ساختار مدل بررسی میکنند. در ادامه، مهمترین دستههای الگوریتمهای رگرسیون معرفی میشوند.
◁ انواع الگوریتم های رگرسیون
۱. رگرسیونهای خطی
در رگرسیونهای خطی، فرض میشود که رابطه بین متغیرهای ورودی و خروجی بهصورت خطی است. این روشها به دلیل سادگی، تفسیرپذیری بالا و کاربرد گسترده، از پرکاربردترین مدلهای رگرسیونی هستند.مهمترین روشهای این دسته عبارتاند از:
- رگرسیون خطی ساده
- رگرسیون خطی چندگانه
در رگرسیون خطی، مدل تلاش میکند با استفاده از یک رابطه خطی، مقدار خروجی را پیشبینی کند. رایجترین روش برای آموزش این مدل، روش حداقل مربعات خطا است. در این روش، مدل ضرایبی را انتخاب میکند که مجموع مربع اختلاف بین مقدار واقعی و مقدار پیشبینیشده کمینه شود.
«برای اطلاعات بیشتر مقاله رگرسیون خطی و چند جملهای را مطالعه کنید.»
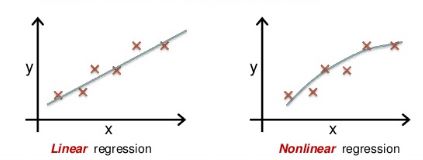
۲. رگرسیونهای غیرخطی
در بعضی مسائل، رابطه بین ورودیها و خروجی بهصورت خطی نیست. در چنین شرایطی، استفاده از رگرسیون خطی ساده ممکن است دقت کافی نداشته باشد. رگرسیونهای غیرخطی برای مدلسازی روابط پیچیدهتر، منحنیشکل یا غیرخطی به کار میروند. نمونههای مهم این دسته عبارتاند از:
- رگرسیون چندجملهای
- رگرسیون نمایی
- رگرسیون لگاریتمی
- رگرسیون تواندار
رگرسیون چندجملهای یکی از رایجترین روشهای غیرخطی است. در این روش، توانهای مختلفی از متغیر ورودی به مدل اضافه میشوند تا رابطه غیرخطی بین ورودی و خروجی بهتر نمایش داده شود.
۳. رگرسیونهای منظمسازیشده
اهی مدل بیش از حد به دادههای آموزشی وابسته میشود و عملکرد خوبی روی دادههای جدید ندارد. به این مشکل بیشبرازش یا Overfitting گفته میشود. رگرسیونهای منظمسازیشده برای کاهش بیشبرازش و کنترل پیچیدگی مدل استفاده میشوند.
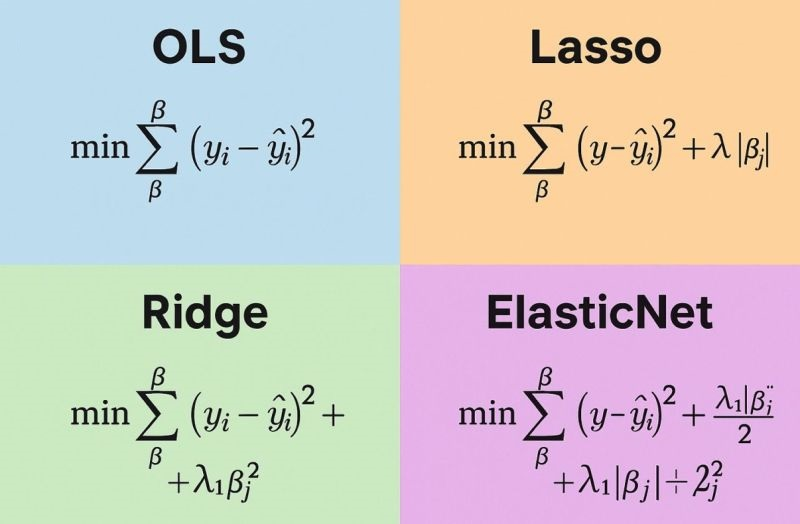
در این روشها، علاوه بر خطای پیشبینی، یک جمله جریمه نیز به تابع هزینه اضافه میشود. این جریمه باعث میشود ضرایب مدل بیش از حد بزرگ نشوند و مدل سادهتر و پایدارتر باقی بماند. مهمترین روشهای این دسته عبارتاند از:
- رگرسیون ریج
- رگرسیون لاسو
- رگرسیون الاستیکنت
در رگرسیون ریج از جریمه L2 استفاده میشود و ضرایب مدل کوچکتر میشوند. در رگرسیون لاسو از جریمه L1 استفاده میشود و بعضی ضرایب میتوانند دقیقاً صفر شوند؛ به همین دلیل لاسو برای انتخاب ویژگی نیز کاربرد دارد. الاستیکنت ترکیبی از ریج و لاسو است و از هر دو نوع جریمه استفاده میکند.
«برای اطلاعات بیشتر مقاله رگرسیون خطی و چند جملهای را مطالعه کنید.»
۴. رگرسیونهای درختی و تجمیعی
رگرسیونهای درختی و تجمیعی (Tree-Based & Ensemble Regression) بهجای استفاده از یک معادله خطی یا فرمول ثابت، دادهها را به چند بخش کوچکتر تقسیم میکنند. سپس برای هر بخش، یک مقدار خروجی پیشبینی میشود. این مدلها برای دادههایی که روابط پیچیده و غیرخطی دارند، بسیار کاربردی هستند. مهمترین روشهای این دسته عبارتاند از:
- رگرسیون درخت تصمیم
- رگرسیون جنگل تصادفی
- رگرسیون گرادیان بوستینگ
- XGBoost Regression
- LightGBM Regression
- CatBoost Regression
درخت تصمیم ساختاری ساده و قابل فهم دارد، اما ممکن است دچار بیشبرازش شود. برای حل این مشکل، روشهایی مانند جنگل تصادفی و گرادیان بوستینگ توسعه یافتهاند. جنگل تصادفی با ترکیب چندین درخت، دقت و پایداری مدل را افزایش میدهد. مدلهای XGBoost، LightGBM و CatBoost نیز از روشهای پیشرفته مبتنی بر بوستینگ هستند.
۵. رگرسیونهای مبتنی بر کرنل
رگرسیونهای مبتنی بر کرنل (Kernel-Based Regression) مدلسازی رابطههای غیرخطی بین ویژگیها و خروجی استفاده میشوند. ایده اصلی این است که دادهها به یک فضای با بُعد بالاتر نگاشت شوند تا روابط پیچیده راحتتر مدل شوند.
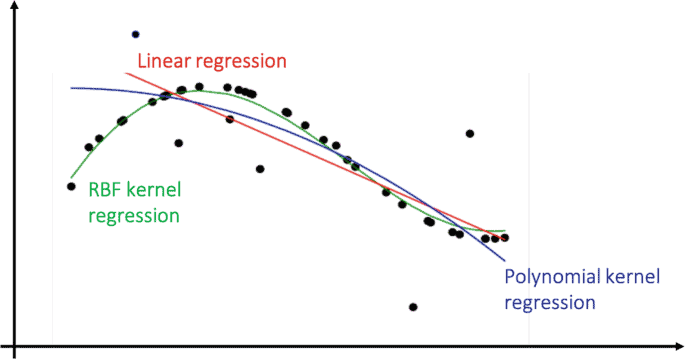
- رگرسیون بردار پشتیبان (SVR) : پیدا کردن تابعی که بیشترین تعداد نقاط در یک حاشیه خطای قابلقبول قرار گیرند. با استفاده از کرنلها (RBF، Polynomial، Sigmoid) میتواند روابط غیرخطی را مدل کند.
- Nadaraya–Watson Regression : کرنلهای رایج در این مدل Gaussian، Epanechnikov برای دادههای نویزی مناسب است ولی در دادههای بزرگ ممکن است کند شود. خروجی جدید برابر با میانگین وزنی خروجی نمونهها با وزندهی کرنلی است.
- Kernel Ridge Regression (KRR) تعادل خوبی بین پیچیدگی و جلوگیری از بیش برازش ایجاد میکند.ترکیبی از رگرسیون ریج و ترفند کرنلی است که مناسب برای مدلسازی روابط غیرخطی با منظم سازی می باشد.
۶. رگرسیونهای احتمالاتی و بیزین
در برخی مسائل، نوع خروجی یا توزیع دادهها با فرضیات رگرسیون خطی معمولی سازگار نیست. در چنین شرایطی از مدلهای احتمالاتی و تعمیمیافته استفاده میشود. این مدلها بیشتر در آمار، علوم پزشکی، اقتصاد و تحلیل دادههای شمارشی کاربرد دارند. نمونههای مهم این دسته عبارتاند از:
- رگرسیون لجستیک (Logistic Regression) با وجود اینکه نام آن «رگرسیون» است، بیشتر برای طبقهبندی استفاده میشود. خروجی آن معمولاً یک احتمال بین ۰ و ۱ است.
- رگرسیون پواسون (Poisson Regression) برای دادههای شمارشی مناسب است؛ یعنی زمانی که خروجی تعداد رخدادها باشد، مثل تعداد ضربان، تعداد خطاها یا تعداد رویدادها در یک بازه زمانی.
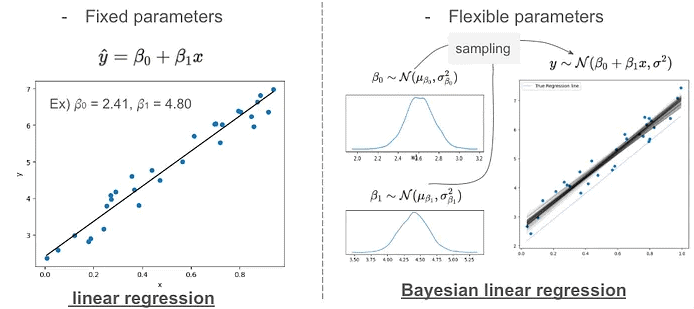
- رگرسیون خطی بیزی (Bayesian Linear Regression) در این روش، ضرایب مدل بهجای مقادیر ثابت، بهصورت متغیرهای تصادفی در نظر گرفته میشوند. نتیجه این کار، یک پیشبینی همراه با عدمقطعیت است.
- رگرسیون فرآیند گاوسی (Gaussian Process Regression) یک روش بیزی غیرپارامتری است که بهجای یادگیری مستقیم ضرایب، روی تابعهای ممکن یک توزیع تعریف میکند. این روش علاوه بر پیشبینی، میزان عدمقطعیت را هم ارائه میدهد.
سایر مدلهای مرتبط
- رگرسیون گاما (Gamma Regression)
- رگرسیون باینومیال (Binomial Regression)
۷. رگرسیونهای مبتنی بر شبکه عصبی
شبکههای عصبی یکی از روشهای قدرتمند برای مدلسازی روابط پیچیده بین دادهها هستند. زمانی که حجم داده زیاد باشد یا رابطه بین ورودی و خروجی بسیار پیچیده باشد، میتوان از شبکههای عصبی برای مسائل رگرسیونی استفاده کرد.نمونههای این دسته عبارتاند از:
- شبکه عصبی پرسپترون چندلایه برای رگرسیون
- مدلهای عمیق برای رگرسیون
- CNN Regression
- RNN/LSTM Regression
این مدلها در حوزههایی مانند پردازش تصویر، تحلیل سیگنال، سریهای زمانی و دادههای پزشکی کاربرد زیادی دارند. برای مثال، در تحلیل سیگنالهای سری زمانی میتوان از شبکههای عصبی برای پیشبینی ویژگیهای عددی یا تحلیل الگوهای پیچیده در داده های سری زمانی استفاده کرد.
۸. رگرسیون مبتنی بر همسایگی
رگرسیون مبتنی بر همسایگی (Instance-Based Regression) یعنی برای پیشبینی مقدار یک نمونه جدید، به نمونههای مشابه نزدیک در دادههای آموزش نگاه میکنیم، نه اینکه یک فرمول کلی یاد بگیریم.اگر ورودی جدید x باشد، مقدار خروجی را از روی همسایههای نزدیک آن تخمین میزنیم
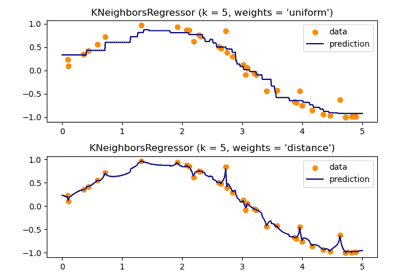
- k-NN Regression: میانگین یا میانگین وزنی همسایه نزدیک
- Distance-weighted Regression: همسایههای نزدیکتر وزن بیشتری دارند
این روش بسیار رایج ساده و قابل فهم است با اینکه برای روابط غیرخطی عملکرد خوبی دارد اما برای داده های زیاد کند اسن و به مقیاس ویژگیها حساس است
۹ . رگرسیون مقاوم
رگرسیونهای مقاوم (Robust Regression) برای زمانی هستند که دادههای تو دارای آرتیفکت یا دادههای پرت زیاد هستند که رگرسیون معمولی (OLS) را خراب میکنند.
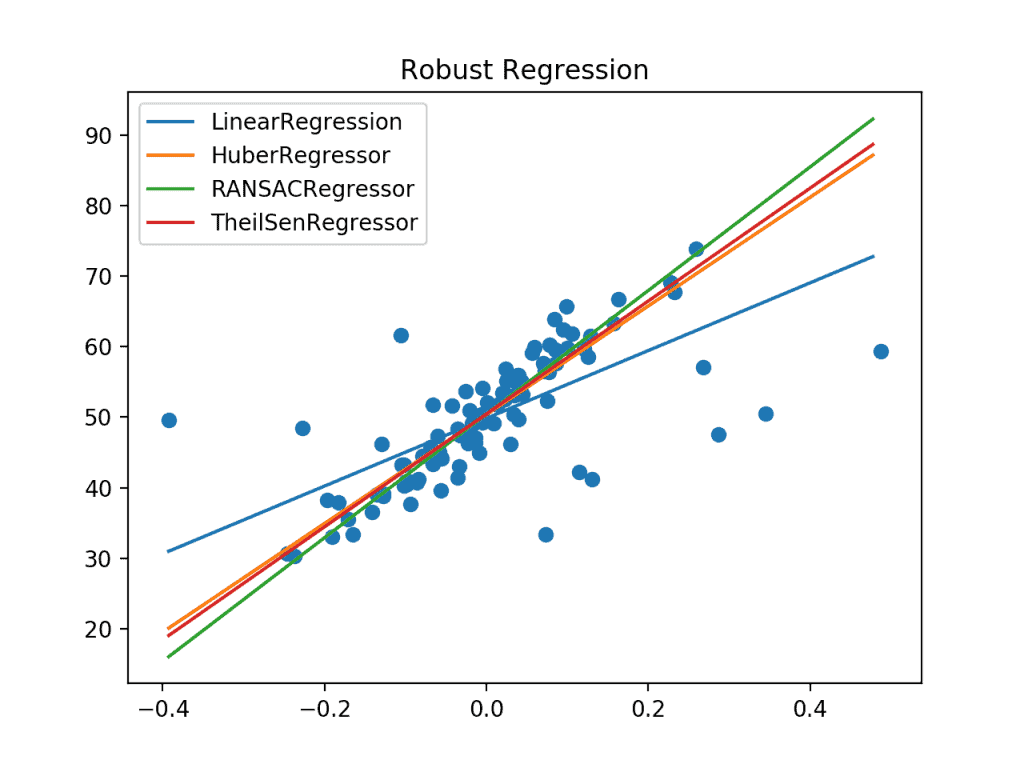
- Huber Regression : این روش ترکیبی از MSE (برای دادههای نزدیک) و MAE (برای دادههای پرت) است.اگر خطا کوچک باشد، تابع هزینه درجه دوم (مشابه OLS) است. اگر خطا بزرگتر از حد آستانه باشد، به صورت خطی رفتار میکند تا اثر دادههای پرت را کم کند.
- RANSAC (Random Sample Consensus): مدل را فقط روی زیرمجموعهای تصادفی از دادهها (Inliers) میسازد. بعد بررسی میکند چند داده دیگر با این مدل سازگارند. این کار را بارها تکرار میکند و بهترین مدلی که بیشترین Inlier را دارد انتخاب میکند.
- Theil-Sen Estimator.: یک روش مبتنی بر میانه تمام جفتنقطه ها را برمیدارد، شیب هر کدام را حساب میکند و میانه کل این شیبها را به عنوان شیب نهایی انتخاب میکند. بسیار نسبت به دادههای پرت مقاوم است.
مقایسه کلی الگوریتمهای رگرسیون
هر الگوریتم رگرسیون برای نوع خاصی از داده و مسئله مناسبتر است. اگر رابطه بین متغیرها ساده و خطی باشد، رگرسیون خطی انتخاب مناسبی است. اگر دادهها الگوی منحنیشکل داشته باشند، رگرسیون غیر خطی میتواند عملکرد بهتری داشته باشد.
در شرایطی که مدل دچار بیشبرازش میشود یا تعداد ویژگیها زیاد است، روشهایی مانند ریج، لاسو و الاستیکنت مفید هستند. اگر دادهها روابط پیچیده، غیرخطی و تعاملات زیاد بین ویژگیها داشته باشند، مدلهای درختی، SVR یا شبکههای عصبی میتوانند گزینههای مناسبتری باشند.
| دستهبندی | روشهای کلیدی | مزیت اصلی | نقطه ضعف |
|---|---|---|---|
| خطی | ساده، چندگانه | تفسیرپذیری بالا، سرعت زیاد | ناتوانی در مدلسازی روابط پیچیده |
| غیرخطی | چندجملهای، نمایی، لگاریتمی | مناسب برای الگوهای منحنی | ریسک بیشبرازش در درجات بالا |
| منظمسازی | ریج، لاسو، الاستیکنت | کنترل پیچیدگی و جلوگیری از Overfitting | نیاز به تنظیم پارامتر (Hyperparameter) |
| درختی و تجمیعی | Random Forest, XGBoost, LightGBM | دقت بسیار بالا، قدرت مدلسازی بالا | عدم تفسیرپذیری آسان (جعبه سیاه) |
| مبتنی بر کرنل | SVR, Nadaraya-Watson, KRR | عالی برای روابط غیرخطی پیچیده | کند بودن در دادههای بسیار بزرگ |
| احتمالاتی و بیزی | لجستیک، پواسون، GP, بیزی | ارائه تخمین عدمقطعیت (Confidence) | پیچیدگی محاسباتی و ریاضی |
| شبکه عصبی | MLP, CNN, LSTM | قدرتمندترین برای دادههای حجیم/پیچیده | نیاز به داده زیاد و زمان آموزش طولانی |
| مبتنی بر همسایگی | k-NN | ساده و بدون نیاز به آموزش (Training) | بسیار کند در مرحله پیشبینی، حساس به مقیاس |
| مقاوم (Robust) | Huber, RANSAC, Theil-Sen | ایمن در برابر نویز و دادههای پرت (Outliers) | ممکن است نسبت به روشهای عادی کندتر باشد |
معیارهای ارزیابی مدلهای رگرسیون
برای بررسی کیفیت عملکرد مدلهای رگرسیون، از معیارهای مختلفی استفاده میشود. این معیارها نشان میدهند که مقدار پیشبینیشده توسط مدل تا چه اندازه به مقدار واقعی نزدیک است.مهمترین معیارهای ارزیابی عبارتاند از:
میانگین مربعات خطا یا MSE:
ریشه میانگین مربعات خطا یا RMSE:
$$ RMSE = \sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i – \hat{y}_i)^2} $$
میانگین قدر مطلق خطا یا MAE:
ضریب تعیین یا R²:
هرچه مقادیر MSE، RMSE و MAE کمتر باشند، مدل عملکرد بهتری دارد. همچنین هرچه مقدار R² بزرگتر باشد، مدل توانسته است بخش بیشتری از تغییرات داده را توضیح دهد.
جمعبندی دستهبندی
به طور کلی، الگوریتمهای رگرسیون را میتوان به چند گروه اصلی تقسیم کرد:
- رگرسیونهای خطی
- رگرسیونهای غیرخطی
- رگرسیونهای منظمسازیشده
- رگرسیونهای درختی
- رگرسیونهای بردار پشتیبان
- رگرسیونهای احتمالاتی و تعمیمیافته
- رگرسیونهای مبتنی بر شبکه عصبی
انتخاب الگوریتم مناسب به نوع داده، شکل رابطه بین متغیرها، میزان پیچیدگی مسئله و هدف تحلیل بستگی دارد. اگر دادهها ساده و قابل تفسیر باشند، رگرسیون خطی گزینه خوبی است. اگر رابطهها پیچیده و غیرخطی باشند، مدلهایی مانند رگرسیون درختی، SVR یا شبکههای عصبی میتوانند عملکرد بهتری داشته باشند. همچنین اگر هدف کاهش بیشبرازش و افزایش پایداری مدل باشد، روشهایی مانند ریج، لاسو و الاستیکنت کاربرد زیادی دارند.
در مقالات بعدی سایت هر کدام از الگوریتم ها با مثال های پایتون و متلب بررسی خواهد شد.