آموزش نامپای (Numpy): بخش اول

NumPy چیست؟
نامپای (NumPy) مخفف Numerical Python، بنیادیترین کتابخانه متنباز پایتون برای محاسبات علمی، ریاضی و کار با دادههای عددی است.این کتابخانه با معرفی ساختار دادهای بهینهای به نام آرایه چندبُعدی (ndarray)، محدودیت سرعت پایتون را برطرف کرده و امکان انجام عملیات برداری، جبر خطی و محاسبات پیچیده ریاضی روی حجم عظیمی از دادهها را با سرعتی مشابه زبانهای C و C++ فراهم میکند.
عنوان مباحث
نصب NumPy
برای استفاده از NumPy، کافی است آن را در محیط پایتون خود نصب کنید. بهترین و استانداردترین روش استفاده از ابزار pip است.ترمینال (یا Command Prompt) خود را باز کرده و دستور زیر را تایپ کنید:
pip install numpy
اگر از محیط علمی Anaconda استفاده میکنید (که برای پروژههای هوش مصنوعی و دیتاساینس بسیار رایج است)، پیشنهاد میشود از conda استفاده کنید تا مدیریت وابستگیها بهتر انجام شود:
conda install numpy
برای اینکه مطمئن شوید نامپای به درستی نصب شده، یک فایل پایتون بسازید و کد زیر را در آن اجرا کنید:
import numpy as np

# چاپ نسخه نامپای جهت اطمینان از نصب
print(f"نسخه نامپای نصب شده: {np.__version__}")

# تست یک آرایه ساده
test_arr = np.array([1, 2, 3])
print("آرایه تست:", test_arr)
فلسفه نامپای (NumPy)
به علت محدودیتهایی که در داده ساختار های پایه در پایتون وجود داشت منجر شد تا برای انجام محاسبات عددی کتابخانه مخصوص به نام ناپای ایجاد شود. برای درک بهتر محدودیت ها را بررسی میکنیم.
۱. محدودیتهای لیست پایتون
- عدم انجام محاسبات ریاضی مستقیم: در پایتون، عملگر
+بین دو لیست، اعداد را با هم جمع نمیزند؛ بلکه آنها را به یکدیگر میچسباند (الحاق یا Concatenation).
list1 = [1, 2, 3]
list2 = [4, 5, 6]

# خروجی الحاق است، نه جمع ریاضی:
print(list1 + list2)
# خروجی: [1, 2, 3, 4, 5, 6]
- ساختار حافظه و کندی حلقه
for: لیست پایتون دادهها را به صورت اشارهگر در خانههای پراکنده حافظه نگه میدارد. برای هر محاسبه ریاضی، مفسر پایتون مجبور است تکتک عناصر را با حلقه بررسی کند و در هر تکرار نوع داده را بسنجد (Type Checking) که باعث افت شدید سرعت میشود.
۲. مفهوم آرایه در نامپای (ndarray)
نامپای دادهها را به صورت پیوسته در حافظه (Contiguous Memory) و با نوع داده همگن (یکسان) ذخیره میکند. هسته آن با C نوشته شده و محاسبات ریاضی را بدون نیاز به نوشتن حلقه و به صورت برداری انجام میدهد.
import numpy as np

arr1 = np.array([1, 2, 3])
arr2 = np.array([4, 5, 6])

# جمع برداری مستقیم بدون نیاز به حلقه
print(arr1 + arr2)
# خروجی: [5 7 9]
مفهوم همگن بودن داده ها در نامپای به این معنا است که تمام عناصر درون یک آرایه باید دقیقاً یک نوع داده (Data Type) یکسان داشته باشند. اگر درون یک لیست پایتون انواع داده مختلف بریزید و آن را به نامپای تبدیل کنید، نامپای برای حفظ ساختار همگن خود، همه دادهها را به یک نوع مشترک (اصطلاحاً Type Coercion / Upcasting) تبدیل میکند
import numpy as np
# ترکیب عدد صحیح، اعشاری و رشته در یک لیست
mixed_list = [10, 3.14, "ECG"]
# نامپای همه را به رشته (String) تبدیل میکند تا آرایه همگن بماند
arr = np.array(mixed_list)
print(arr)
# خروجی: ['10' '3.14' 'ECG']
print(arr.dtype)
# خروجی: <U32 (رشته یونیکد)
نامپای از چه نوع دادههایی (Data Types) پشتیبانی میکند؟
نامپای بر خلاف پایتون خالص، کنترل بسیار دقیقی روی حافظه و نوع بیتها به شما میدهد:
| دسته نوع داده | کدهای نامپای | کاربرد و مثال |
|---|---|---|
| اعداد صحیح (Integers) | int8, int16, int32, int64 | شمارندهها، برچسب کلاسها، ایندکسها |
| اعداد صحیح بدون علامت (Unsigned) | uint8, uint16, uint32 | پردازش تصویر (پیکسلهای ۰ تا ۲۵۵ در uint8) |
| اعداد اعشاری (Floats) | float16, float32, float64 | محاسبات علمی، سیگنالها، وزنهای یادگیری عمیق |
| اعداد مختلط (Complex) | complex64, complex128 | تبدیل فوریه، تحلیل فرکانسی و مخابرات |
| بولی (Boolean) | bool | ماسکهای شرطی (True / False) |
| رشته و بایت (Strings & Bytes) | string_, unicode_ | متنها و برچسبهای متنی ثابت |
مفاهیم پایه
برای تسلط بر پایتون و نامپای، باید تفاوت این سه مفهوم را مثل کف دست بشناسی:
۱. تابع (Function)
یک ابزار مستقل است که خارج از شیء تعریف شده و ما به آن «ورودی» میدهیم تا کاری انجام دهد.
- نحوه فراخوانی:
function_name(input) - مثال:
np.zeros((2, 3)). اینجاzerosیک ابزار مستقل در کتابخانه نامپای است.
۲. متد (Method)
یک ابزار اجرایی است که وابسته به شیء است. یعنی فقط وقتی آن شیء (مثلاً یک آرایه) را داشته باشیم، میتوانیم از متدهایش استفاده کنیم.
- نحوه فراخوانی:
object.method_name() - مثال:
arr.reshape(2, 2). اینجاreshapeیک متد است که فقط روی آرایههای نامپای کار میکند.
۳. ویژگی (Attribute) – یا صفت
«شناسنامه» یا «وضعیت فعلی» شیء است. عملیاتی انجام نمیدهد، فقط اطلاعاتی را درباره وضعیت شیء به ما گزارش میدهد.
مثال: arr.shape. اینجا ما چیزی را تغییر نمیدهیم، فقط داریم ابعاد فعلیِ آرایه را میخوانیم.
نحوه فراخوانی: object.attribute_name (بدون پرانتز!)
import numpy as np

arr = np.array([[1, 2], [3, 4]])

# --- تفاوت shape (ویژگی vs تابع) ---
print(f"ویژگی: {arr.shape}")    # خروجی: (2, 2)
print(f"تابع: {np.shape(arr)}")  # خروجی: (2, 2)

# --- تفاوت sum (متد vs تابع) ---
print(f"متد: {arr.sum()}")       # خروجی: 10
print(f"تابع: {np.sum(arr)}")    # خروجی: 10
متدهای اصلی ساخت آرایه (Functions)
تابع np.array()
تابع np.array() اصلیترین ابزار برای تبدیل ساختارهای دادهای پایتون (مثل لیستها و تاپلها) به «آرایههای نامپای» (ndarray) است.
numpy.array(object, dtype=None, copy=True, order='K', subok=False, ndmin=0)
object: داده ورودی (لیست، تاپل، یا آرایه دیگر).dtype: (اختیاری) نوع داده آرایه (مثلnp.float32,np.int64). اگر ننویسید، نامپای خودش حدس میزند.copy: (اختیاری) اگرTrueباشد (پیشفرض)، یک کپی از دادهها در حافظه جدید ساخته میشود.ndmin: (اختیاری) حداقل تعداد ابعاد. مثلاً اگرndmin=2بگذارید، حتی اگر لیست شما یکبعدی باشد، آن را به آرایه ۲بعدی تبدیل میکند.order: ترتیب قرار گرفتن اعداد داخل ارایه های نامپای که در حالت پیش فرض به صورت سطری هست.
import numpy as np

# ۱ بعدی (بردار)
arr1 = np.array([1, 2, 3])

# ۲ بعدی (ماتریس)
arr2 = np.array([[1, 2], [3, 4]])

# ۳ بعدی (تنسور)
# یک لیستِ شامل دو ماتریس ۲×۲
arr3 = np.array([[[1, 2], [3, 4]], [[5, 6], [7, 8]]])

print("ابعاد آرایه ۳ بعدی:", arr3.shape) # خروجی: (2, 2, 2)
ویژگیها و متدهای آرایه
الف) استفاده از dir()
این دستور لیست تمام ویژگیها (Attributes) و متدها (Methods) یک شیء را به شما نشان میدهد.
x = np.array([1, 2, 3])
print(dir(x)) # لیست بلندبالایی از تمام قابلیتها چاپ میشود
ب) ویژگیهای توصیفی (Attribute – بدون پرانتز):
در پایتون، ویژگی (Attribute) به شناسنامه و اطلاعات ساختاری یک شیء گفته میشود. از آنجا که این ویژگیها از قبل در حافظه ثبت شدهاند، برای خواندن آنها هیچ نیازی به نوشتن پرانتز () نیست (برخلاف توابع). وقتی یک آرایه نامپای ساخته میشود، ۴ ویژگی کلیدی ساختار آن را توصیف میکنند:
x.shape (ابعاد آرایه)
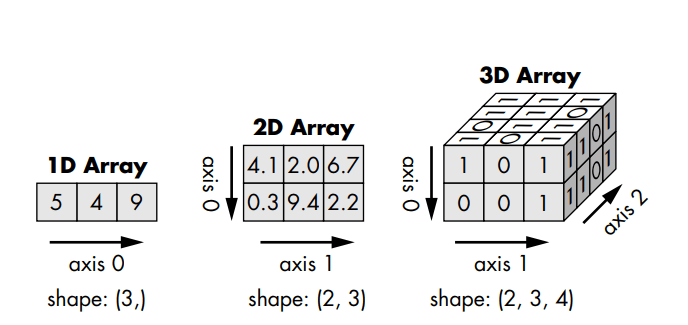
این ویژگی یک تاپل (Tuple) برمیگرداند که تعداد اعضا را در هر بعد (سطر، ستون، عمق و…) نشان میدهد.اهمیت این ویژگی در این است که، در جبر خطی و هوش مصنوعی، اولین شرط برای ضرب دو ماتریس یا ارسال داده به مدل، همخوانی shape است. مثال: (3, 4) یعنی یک ماتریس با ۳ سطر و ۴ ستون.
arr = np.array([[10, 20, 30],
                [40, 50, 60]])

print(arr.shape)
# خروجی: (2, 3) -> یعنی 2 سطر و 3 ستون
ویژگی x.ndim (تعداد ابعاد – Number of Dimensions)
یک عدد صحیح را بر می گرداند که مشخص کننده تعداد ابعاد – Number of Dimensions آرایه است، اصطلاعا مشخص می کند آرایه چند بُعدی است.
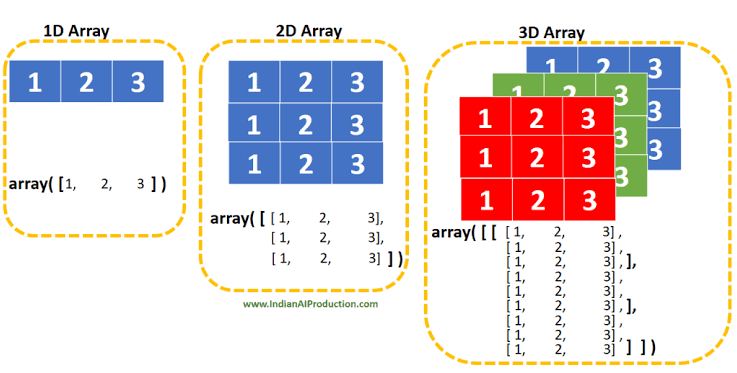
ndim = 1: بردار ۱ بعدی (یک سیگنال ساده صوتی و …).ndim = 2: ماتریس ۲ بعدی (سیگنال چندلید، جدول اکسل یا تصویر سیاهسفید).ndim = 3: تانسور ۳ بعدی (تصویر رنگی با کانالهای RGB).
arr1d = np.array([1, 2, 3])
arr2d = np.array([[1, 2], [3, 4]])

print(arr1d.ndim)  # خروجی: 1 (بردار)
print(arr2d.ndim)  # خروجی: 2 (ماتریس دو بعدی)
ویژگی x.dtype (نوع داده داخل آرایه)
چون آرایههای نامپای همگن هستند، تمام عناصر نوع داده یکسانی دارند. این ویژگی مشخص میکند که دادهها از چه جنسی هستند (مثلاً int32، int64، float64 و …).
arr_int = np.array([1, 2, 3])
arr_float = np.array([1.5, 2.0, 3.7])

print(arr_int.dtype)    # خروجی: int64 (یا int32 بسته به سیستم)
print(arr_float.dtype)  # خروجی: float64
ویژگی x.size (تعداد کل عناصر)
تعداد کل دادههای موجود در سراسر آرایه را میشمارد (حاصلضرب سطر در ستون در لایهها). همیشه برابر است با حاصلضرب تمام اعداد موجود در shape. اگر shape = (3, 4) باشد → مقدار size = 12 خواهد بود.
arr = np.array([[1, 2, 3, 4],
                [5, 6, 7, 8]])

print(arr.size)
# خروجی: 8 (چون آرایه 2 سطر و 4 ستون دارد: 2 * 4 = 8)
ب) متدهای عملیاتی (Method – با پرانتز):
متدها توابعی هستند که مستقیماً روی دادههای شیء اجرا میشوند تا محاسباتی انجام دهند یا ساختار داده را تغییر دهند. چون یک عملیات اجرایی هستند، همیشه پرانتز () دارند.
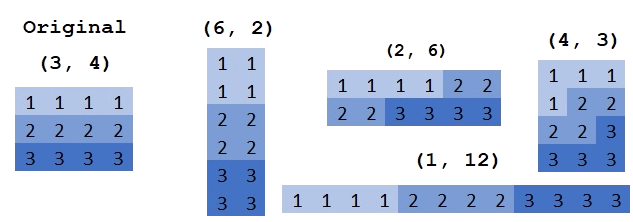
متد x.reshape(rows, cols) (تغییر شکل آرایه)
بدون تغییر دادن دادهها، آرایش سطر و ستون آرایه را تغییر میدهد. نکته مهم این است که حاصلضرب ابعاد جدید باید دقیقاً برابر با size اولیه باشد.
# یک آرایه یکبعدی با ۶ عنصر
arr = np.array([1, 2, 3, 4, 5, 6])
# تبدیل به ماتریس ۲ سطر و ۳ ستون
reshaped = arr.reshape(2, 3)
print(reshaped)
# خروجی:
# [[1 2 3]
# [4 5 6]]
متد x.flatten() (تبدیل به بردار یکبعدی)
یک ماتریس چندبُعدی را پهن میکند و همه عناصر را پشت سر هم در یک آرایه ۱ بعدی ساده قرار میدهد (یک کپی جدید از داده برمیگرداند)
matrix = np.array([[1, 2],
                   [3, 4]])

flat = matrix.flatten()

print(flat)
# خروجی: [1 2 3 4]
متد x.astype(new_type) (تبدیل نوع داده)
برای تغییر نوع داده (Casting) استفاده میشود؛ مثلاً تبدیل مقادیر اعشاری به عدد صحیح، یا تبدیل اعداد به رشته.
arr_float = np.array([1.2, 3.8, 5.5])
# تبدیل اعشاری به عدد صحیح (بخش اعشار حذف میشود)
arr_int = arr_float.astype(int)
print(arr_int) # خروجی: [1 3 5]
print(arr_int.dtype) # خروجی: int64 (یا int32)
ایندکسگذاری، برشزدن و فیلتر شرطی
۱. دسترسی به دادهها (Indexing)
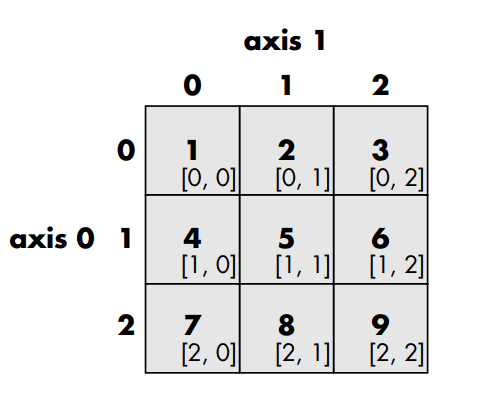
دسترسی به درایهها با الگوی array[سطر, ستون] انجام میشود (شمارهگذاری از صفر شروع میشود).
import numpy as np

mat = np.array([
    [10, 20, 30],
    [40, 50, 60],
    [70, 80, 90]
])

# سطر اول (ایندکس ۰)، ستون دوم (ایندکس ۱)
print(mat[0, 1])
# خروجی: 20

# دسترسی به سطر آخر و ستون آخر با ایندکس منفی
print(mat[-1, -1])
# خروجی: 90
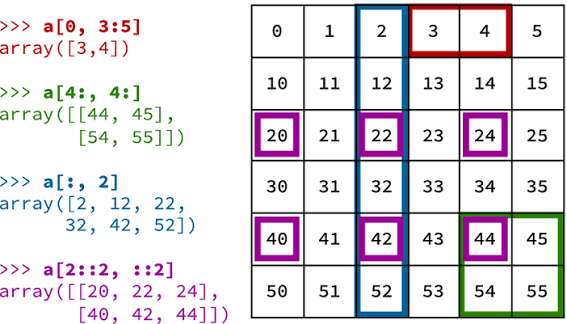
۲. برشزدن دوبعدی (2D Slicing)
array[row_start:row_stop, col_start:col_stop]
import numpy as np
mat = np.array([
[10, 20, 30, 40],
[50, 60, 70, 80],
[90, 100, 110, 120]
])
# انتخاب سطرهای ۰ و ۱، و ستونهای ۱ و ۲
sub_mat = mat[0:2, 1:3]
print(sub_mat)
# خروجی:
# [[20 30]
# [60 70]]
# انتخاب تمام سطرهای ستون دوم (علامت : یعنی همه سطرها)
col_one = mat[:, 1]
print(col_one)
# خروجی: [ 20 60 100]
# انتخاب کل سطر دوم
row_one = mat[1, :]
print(row_one)
# خروجی: [50 60 70 80]
۳. فیلتر شرطی (Boolean Masking)
اعمال شرط روی آرایه، یک ماسک بولی (True/False) تولید میکند. با قرار دادن این ماسک درون براکت، عناصر منطبق استخراج میشوند.
import numpy as np
data = np.array([5, 12, 18, 7, 25, 30, 3])
# ساخت ماسک شرطی
mask = data > 10
print("ماسک بولی:", mask)
# خروجی: [False True True False True True False]
# فیلتر دادهها با استفاده از ماسک
filtered = data[mask]
print("اعداد بزرگتر از ۱۰:", filtered)
# خروجی: [12 18 25 30]
۴. ترکیب شرطهای منطقی
در نامپای برای ترکیب چند شرط:
- از
&(AND) و|(OR) استفاده میشود (نه کلماتandوor). - قرار دادن هر شرط داخل پرانتز
()الزامی است.
import numpy as np

scores = np.array([8, 11, 14, 17, 19, 9, 20])

# استخراج نمرات بین ۱۰ تا ۱۸
selected = scores[(scores >= 10) & (scores < 18)]
print("نمرات بازه ۱۰ تا ۱۸:", selected)
# خروجی: [11 14 17]

# تغییر مقادیر بر اساس شرط (تغییر تمام نمرات مردودی به صفر)
scores[scores < 10] = 0
print("آرایه پس از اصلاح نمرات:", scores)
# خروجی: [ 0 11 14 17 19  0 20]
کاربرد های نامپای؟
نامپای به تنهایی فقط یک کتابخانه ریاضی نیست، بلکه زیربنای تمام کتابخانههای مدرن پایتون است:
- پردازش سیگنال و دادههای سری زمانی:
- سیگنالهای زیستی (مانند ECG، EEG) و دادههای مخابراتی به عنوان آرایههای ۱ بعدی و ۲ بعدی در نامپای فیلتر و تحلیل میشوند.
- پردازش تصویر و بینایی ماشین (OpenCV):
- هر تصویر در کامپیوتر در واقع یک آرایه نامپای است (تصویر سیاهسفید: ماتریس ۲ بعدی، تصویر رنگی: ماتریس ۳ بعدی از کانالهای RGB).
- پایه و اساس یادگیری ماشین و یادگیری عمیق (PyTorch, TensorFlow, Scikit-learn):
- تانسورها (Tensors) در تورچ و تنسورفلو ساختاری کاملاً مشابه
ndarrayنامپای دارند.
- تانسورها (Tensors) در تورچ و تنسورفلو ساختاری کاملاً مشابه
- جبر خطی و تبدیلهای فوریه (Linear Algebra & FFT):
- ضرب ماتریسها، محاسبه دترمینان، مقادیر ویژه (Eigenvalues) و تبدیل فوریه سریع برای تحلیلهای فرکانسی.
جمعبندی
در این بخش آموختیم که نامپای (NumPy) به دلیل ذخیرهسازی دادههای همگن در حافظه پیوسته و بهرهگیری از ساختار بهینه ndarray، هسته اصلی محاسبات سریع و علمی در پایتون است. همچنین با نحوه ساخت آرایهها، ویژگیهای پایهای مانند shape و dtype، و روشهای دسترسی و فیلتر شرطی دادهها آشنا شدیم. در ادامه به مفاهیم محاسبات جبر خطی می پردازیم .