تاریخچه پردازش زبان طبیعی


تاریخچه پردازش زبان طبیعی: از رؤیاهای اولیه تا انقلاب AI
پردازش زبان طبیعی (Natural Language Processing یا NLP) یکی از جذابترین و چالشبرانگیزترین حوزههای هوش مصنوعی است. NLP پلی است میان دنیای پیچیده زبان انسان و دنیای دقیق کامپیوتر. داستان آن روایت رؤیاهایی است که گاه به شکست انجامیدند، گاه با هوشی بینظیر پیش رفتند و در نهایت به انقلابی در تعامل انسان و ماشین انجامیدند. این مقاله سفری تاریخی از نخستین ایدههای ترجمه ماشینی تا مدلهای غولپیکر زبانی امروزی است.
فهرست متن
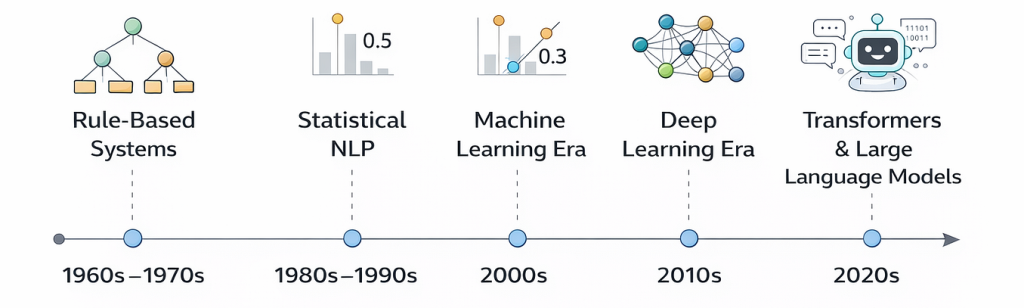
- عصر نمادگرایی (۱۹۵۰ تا اوایل ۱۹۶۰)
- نسل اول NLP مبتنی بر قواعد (۱۹۶۰-۱۹۷۰)
- نسل دوم NLP: عصر آماری (اواخر ۱۹۸۰ – ۱۹۹۰)
- عصر یادگیری ماشین (۱۹۹۰ – ۲۰۱۰)
- عصر شبکههای عصبی و یادگیری عمیق (۲۰۱۰ تا به امروز)
- حوزههای پژوهشی و کاربردیNLP
- جمعبندی؛ از قواعد خشک تا فهم مبتنی بر داده
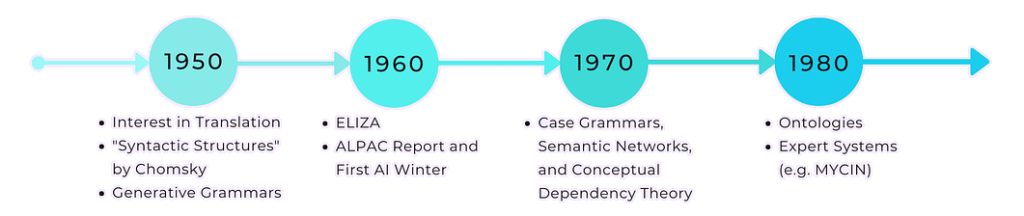
عصر نمادگرایی (۱۹۵۰- ۱۹۶۰)
ایده ترجمه ماشینی به قرن هفدهم و فیلسوفانی مانند لایبنیتس و دکارت بازمیگردد، اما هرگز به ساخت ماشین واقعی منجر نشد. نخستین گامهای عملی در اواسط قرن بیستم با ثبت حق امتیاز ماشینهای ترجمهکننده در دهه ۱۹۳۰ (مانند طرحهای آرستروئنی و ترویانسکی) برداشته شد. با این حال، تولد واقعی NLP پس از جنگ جهانی دوم و با ظهور کامپیوترهای دیجیتال رقم خورد.
۱. جرقههای اولیه: تورینگ و چامسکی
سال ۱۹۵۰ نقطه عطفی در تاریخ NLP و هوش مصنوعی بود. آلن تورینگ مقاله «ماشینهای محاسبهگر و هوش» را منتشر کرد و تست تورینگ را پیشنهاد داد؛ آزمونی که میگفت اگر ماشینی در مکالمه نوشتاری چنان پاسخ دهد که انسان نتواند آن را از انسان واقعی تشخیص دهد، میتوان آن را هوشمند دانست. اگرچه تورینگ مستقیماً NLP را تعریف نکرد، اما این آزمون مبنای مهمی برای ارزیابی توانایی زبانی ماشینها شد.
در سال ۱۹۵۷، نوآم چامسکی با کتاب ساختارهای نحوی و نظریه دستور زایشی انقلابی در زبانشناسی ایجاد کرد. او معتقد بود زبان را میتوان با مجموعهای از قواعد ساختاری توصیف و مدلسازی کرد. این نگاه، پایهگذار رویکردهای نمادگرا یا قاعدهمحور در NLP شد که فرض میکردند با ارائه قواعد زبانی کافی به ماشین، او خواهد توانست زبان را بفهمد.
۲. آزمایش جرجتاون و موج خوشبینی اولیه
در سال ۱۹۵۴، دانشگاه جرجتاون و IBM در آزمایشی موفق شدند بیش از شصت جمله روسی را به انگلیسی ترجمه کنند. این موفقیت اولیه، خوشبینی اغراقآمیزی ایجاد کرد و پژوهشگران پیشبینی کردند مشکل ترجمه ماشینی ظرف ۳ تا ۵ سال حل میشود. اما این خوشبینی زودگذر بود، زیرا مشخص شد ترجمه فقط جایگزینی واژه نیست و زبان سرشار از ابهام، بافت، کنایه و وابستگی به دانش دنیای واقعی است که ماشینهای آن زمان از درک آن عاجز بودند.
نسل اول NLP مبتنی بر قواعد (۱۹۶۰-۱۹۷۰)
ماشینهای اولیه: ELIZA و SHRDLU
دهههای ۱۹۶۰ و ۱۹۷۰ شاهد ظهور دو سیستم بسیار مهم در تاریخ NLP بود.
ELIZA (۱۹۶۴-۱۹۶۶، ساخته جوزف وایزنباوم در MIT) نخستین سیستم گفتوگومحور بود که نقش رواندرمانگر را بازی میکرد. این برنامه با استفاده از الگوهای ساده و کلیدواژهها، جملات کاربر را به شکل سوال بازنویسی میکرد (مثلاً «سرم درد میکند» → «چرا میگویید سرتان درد میکند؟»). اگرچه ELIZA درک واقعی از معنا نداشت، اما نشان داد قواعد زبانی ساده میتوانند توهم درک و تعامل انسانی ایجاد کنند.
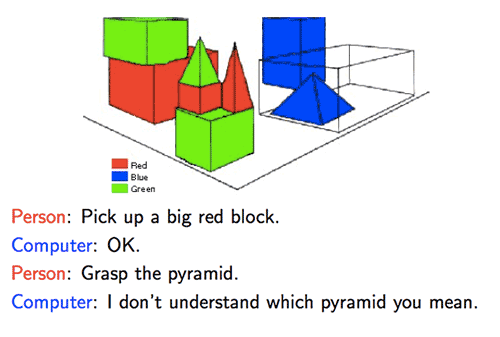
در سال ۱۹۷۰، تری وینوگراد سیستم SHRDLU را در محیط محدود «دنیای بلوکها» طراحی کرد که شامل اشیایی مانند مکعب، هرم و جعبه بود. کاربران میتوانستند با زبان طبیعی دستور دهند («هرم قرمز را بردار») یا سوال بپرسند («جعبه آبی چه چیزی در خود دارد؟»). برخلاف ELIZA، SHRDLU به معنا، ارجاع و استدلال درباره جهان توجه داشت، اما قدرت آن شدیداً وابسته به محیط کوچکش بود و در دنیای واقعی قابل تعمیم نبود.
دههی ۱۹۷۰: هستیشناسیهای مفهومی و بازنمایی دانش
در دهه ۱۹۷۰، تمرکز از دستور زبان به سمت «درک معنا و دانش دنیای واقعی» رفت. پژوهشگران با ساخت هستیشناسیهای مفهومی، تلاش کردند مدلی از جهان را به ماشین بفهمانند. سیستمهایی مانند MARGIE، SAM و PAM از راجر شانک تلاش کردند رویدادها و روابط را ساختاریافته نمایش دهند. همزمان، ربات PARRY با شخصیتی پارانوئید ساخته شد. این سیستمها اگرچه ابتدایی بودند، اما پایهگذار ایده تعامل زبانی انسان و ماشین شدند.
افول و ظهور دوباره: گزارش ALPAC
گزارش کمیتهی مشاورهای پردازش زبان خودکار ALPAC در سال ۱۹۶۶ با اعلام ناکارآمدی ترجمه ماشینی، باعث قطع بودجه و رکود تحقیقات شد. دلیل اصلی این شکست، ناتوانی ماشینها در درک بافت، معنا و دانش عمومی بود؛ مسائلی که بدون آنها پردازش دقیق زبان ممکن نبود.
اندکی پیشرفت در میان رکود (۱۹۶۶ تا ۱۹۸۰)
اگرچه گزارش ALPAC ضربهای سنگین به پژوهشهای ترجمه ماشینی زد، اما تحقیقات در NLP کاملاً متوقف نشد. در دهههای بعد، ابزارهای مهمی مانند شبکههای انتقال افزوده (ATN) توسط ویلیام وودز (۱۹۷۰) برای تحلیل نحوی جملات، و دستور نقشها توسط چارلز فیلمور برای تحلیل روابط معنایی (فاعل، مفعول، ابزار، مقصد) توسعه یافتند. این پیشرفتها هرچند همچنان در چارچوب رویکردهای نمادین بودند، اما گامهایی مهم در جهت درک عمیقتر زبان محسوب میشدند.
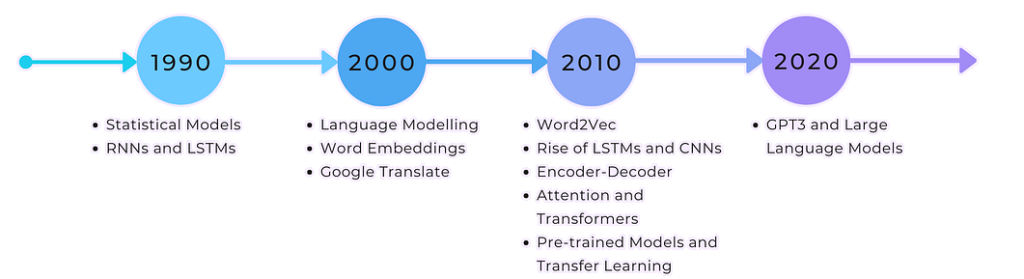
نسل دوم NLP: عصر آماری (اواخر ۱۹۸۰ – ۱۹۹۰)
با افزایش چشمگیر دادههای متنی و رشد توان محاسباتی، روشهای آماری جایگزین رویکردهای کاملاً قانونمحور شدند. در این نسل، مدلها به جای تکیه بر قواعد دستساز، از الگوهای آماری موجود در داده یاد میگرفتند و زبان را به عنوان یک پدیدهی احتمالی مینگریستند.
دو عامل اصلی در تحول NLP نقش داشتند:
۱) افزایش قدرت پردازشی کامپیوترها (طبق قانون مور) که اجرای الگوریتمهای پیچیدهتر روی دادههای حجیم را ممکن کرد.
۲) کاهش سلطه رویکردهای قاعدهمحور؛ پژوهشگران دریافتند زبان واقعی بهتر از دل دادههای واقعی فهمیده میشود تا قواعد دستساز.
ظهور مدلهای آماری – اوایل دهه ۱۹۹۰
مدل زبانی N-gram با وجود سادگی بر اساس احتمال وقوع دنبالهای از کلمات، زبان را مدل میکردند. این روش پایه بسیاری از سیستمهای اولیه تشخیص گفتار و ترجمه ماشینی را تشکیل داد.
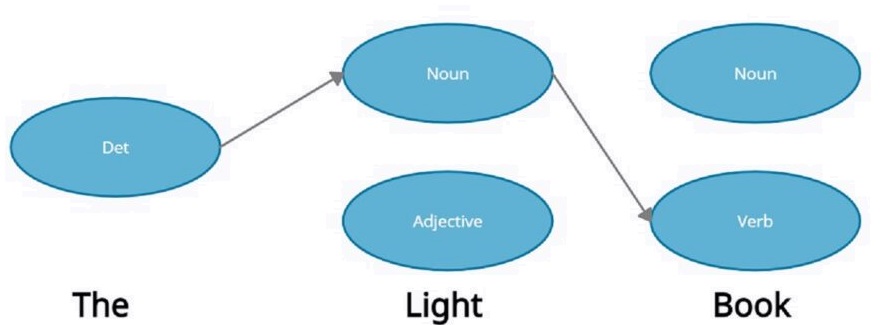
یکی از نخستین موفقیتهای رویکرد آماری در تشخیص گفتار با استفاده از مدلهای مخفی مارکوف (HMM) در IBM رخ داد که نتایج بهتری نسبت به روشهای قاعدهمحور داشت.این روش در تشخیص گفتار و برچسبزنی نقش دستوری (POS Tagging) بسیار موفق عمل کرد
چارچوب مهم این دوره، مدل «کانال پرنویز» (Noisy-Channel Model) بود که جمله مشاهدهشده را نسخهای تحریفشده از جمله اصلی میدانست و سیستم باید با استفاده از احتمالها، بهترین بازسازی را حدس میزد. این مدل در تصحیح املایی، تشخیص گفتار و ترجمه ماشینی بسیار اثرگذار بود.
دستاوردهای کلیدی: برچسبزنی و ترجمه
یکی از موفقیتهای چشمگیر دوره آماری، برچسبزنی نقش دستوری (POS Tagging) بود که سیستمها با دقت بیش از ۹۵ درصد نقشهایی مانند اسم، فعل، صفت و حرف اضافه را برای هر واژه تعیین میکردند. این دستاورد بسیار مهم بود، زیرا برچسبزنی نقش دستوری پیشنیاز بسیاری از تحلیلهای پیچیدهتر زبانی محسوب میشود.
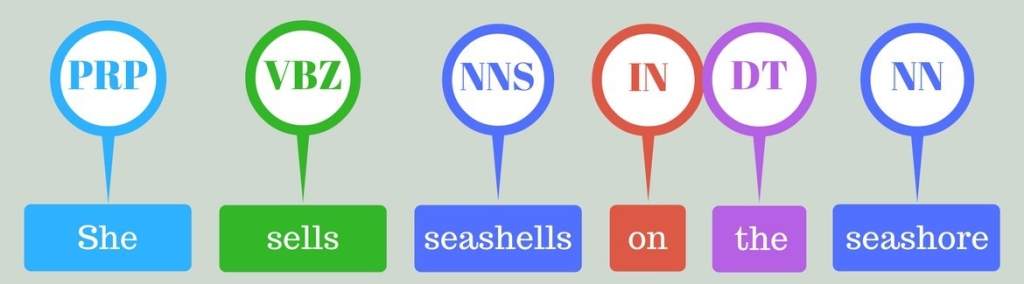
در دوره آماری، ترجمه ماشینی آماری (SMT) رشد چشمگیری داشت. پژوهشگران IBM از حجم عظیم متون دوزبانه (مانند اسناد مجلس کانادا و اتحادیه اروپا) برای آموزش مدلهای خود استفاده کردند. برخلاف رویکردهای قاعدهمحور پیشین، این سیستمها مستقیماً از دادههای واقعی الگو میگرفتند و نتایج بهتری ارائه میدادند.
نقش پیکرههای زبانی
مدلهای آماری بدون دادهی کافی عملاً بیفایده بودند. به همین دلیل، توسعهی پیکرههای زبانی یا Corpora در این دوره اهمیت زیادی پیدا کرد. پیکرههایی مانند پیکرهی براون و همچنین درختبانکها که در آنها ساختار نحوی جملات نیز برچسبگذاری شده بود، منابع بسیار ارزشمندی برای آموزش و ارزیابی سیستمهای NLP شدند
عصر یادگیری ماشین (۱۹۹۰ – ۲۰۱۰)
اواخر دهه ۱۹۹۰ – اوجگیری در طبقهبندی متن
با گسترش وب و در دسترس قرار گرفتن حجم عظیم دادههای متنی، نیاز به طبقهبندی خودکار اسناد افزایش یافت. دو روش آماری در این حوزه به اوج خود رسیدند:
- – Naive Bayes: روشی ساده اما قدرتمند بر اساس قضیه بیز که با فرض استقلال ویژگیها، برای طبقهبندی اسناد استفاده میشد. کاربردهای شاخص: فیلتر کردن ایمیلهای اسپم، دستهبندی اخبار.
- – مکانیزم بردار پشتیان (SVM) طبقهبندیکنندهای قدرتمند که با یافتن مرز تصمیم بهینه در فضای با ابعاد بالا، عملکرد بسیار خوبی در دستهبندی متون داشت. SVM در مسائلی مانند تشخیص احساسات و تحلیل نظرکاوی به موفقیتهای چشمگیری دست یافت.
اوایل دهه ۲۰۰۰ – رفع محدودیتهای HMM
HMM یک مدل تولیدی با محدودیت فرض استقلال ویژگیها بود که نمیتوانست از ویژگیهای پیچیده و همپوشان استفاده کند. CRF (ارائهشده در ۲۰۰۱) به عنوان راهحل، یک مدل شرطی است که مستقیماً احتمال شرطی برچسبها را مدل میکند، نیازی به فرض استقلال ندارد و در مسائل برچسبزنی دنبالهای مانند NER و POS Tagging عملکرد بهتری نسبت به HMM دارد.
عصر دادههای بزرگ و یادگیری بدون نظارت
با گسترش وب در اواخر دههی ۱۹۹۰، حجم عظیمی از دادههای متنی خام (بدون برچسب) در دسترس قرار گرفت.این موضوع پژوهشگران را به سمت روشهای یادگیری بدون نظارت و نیمهنظارتی سوق داد. در این رویکردها، مدلها میتوانستند از دادههایی که برچسبگذاری نشده بودند نیز الگو یاد بگیرند. اگرچه این روشها همیشه به دقت مدلهای کاملاً نظارتی نمیرسیدند، اما حجم بسیار زیاد داده در بسیاری از مواقع این ضعف را جبران میکرد.
عصر شبکههای عصبی و DL: انقلابی دیگر (۲۰۱۰ تا به امروز)
دههی ۲۰۱۰، با ورود یادگیری عمیق (Deep Learning)، انقلابی دیگر در NLP رقم زد. این روشها بر پایهی شبکههای عصبی، به جای قواعد دستنویس یا مدلهای آماری ساده، به یادگیری بازنماییهای پیچیده از زبان میپردازند.
۱. ظهور بردارهای واژه (Word Embeddings)
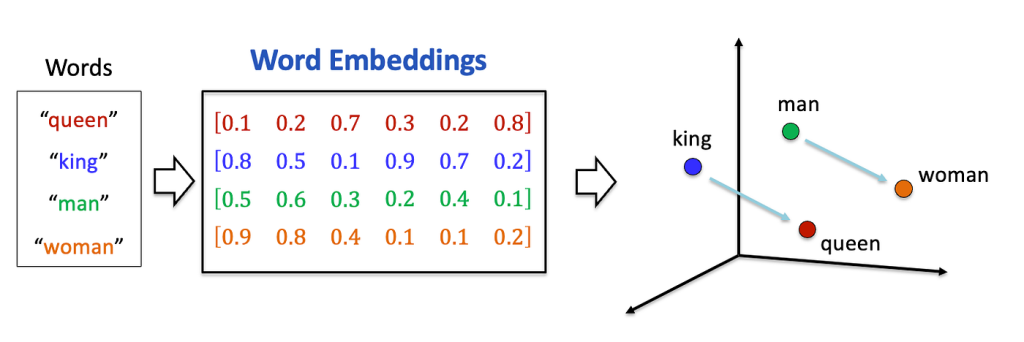
پیش از این، ماشینها کلمات را به صورت نمادهای مستقل و بدون ارتباط با هم میدیدند. با معرفی مدلهایی مانند Word2Vec، هر واژه به یک بردار عددی در فضای چندبعدی تبدیل شد. این یعنی کامپیوتر برای اولین بار توانست بفهمد که «پادشاه» و «ملکه» از نظر معنایی به هم نزدیکترند تا «پادشاه» و «سیب». این بردارها سنگ بنای درک معنایی در ماشین شدند.
۲. مدیریت توالی با شبکههای بازگشتی (RNN و LSTM)
برای درک ترتیب کلمات در جمله، شبکههای بازگشتی RNN و نسخه پیشرفتهاش LSTM به کار رفتند تا حافظه کلمات قبلی را نگه دارند و کلمه بعدی را پیشبینی کنند. این روش در ترجمه ماشینی و تشخیص گفتار انقلابی ایجاد کرد.
شبکههای عصبی در وظایف مختلف NLP از مدلسازی زبان تا خلاصهسازی و ترجمه عملکرد خوبی نشان دادند. ظهور دستیارهای صوتی مانند Siri (۲۰۱۱)، Alexa (۲۰۱۴) و Google Assistant (۲۰۱۶) نشان داد NLP از موضوع آزمایشگاهی به کاربرد واقعی رسیده است.
۳. انقلاب ترانسفورمر (The Transformer)
در سال ۲۰۱۷، با انتشار مقالهی «Attention Is All You Need»، معماری جدیدی به نام ترانسفورمر معرفی شد. تفاوت اصلی این مدل با نسلهای قبل، استفاده از مکانیزم Self-Attention (توجه به خود) است. این مکانیزم به مدل اجازه میدهد هنگام پردازش هر کلمه، به تمام کلمات دیگر جمله نگاه کند و بفهمد کدامیک برای درک معنای آن کلمه مهمتر است. این معماری، محدودیت پردازش ترتیبی را از بین برد و سرعت آموزش را چند برابر کرد.
برای اطلاع بیشتر مکانیزم های توجه در یادگیری ماشین را مطالعه کنید
۴. ظهور مدلهای زبانی بزرگ (LLMs)
با معماری ترانسفورمر، عصر مدلهای زبانی بزرگ مانند BERT و GPT آغاز شد. این مدلها طی دو مرحله آموزش میبینند: ابتدا در مرحله پیشآموزش (Pretraining) روی حجم عظیمی از دادههای اینترنتی دانش عمومی زبان را کسب میکنند، و سپس در مرحله ریزتنظیم (Fine-tuning) برای کارهای خاص مثل خلاصهسازی یا پاسخ به سؤالات تخصصی آماده میشوند.
حوزههای پژوهشی و کاربردیNLP
امروزه NLP به شاخههای تخصصی متعددی تقسیم شده است که هر کدام بخشی از نیازهای دنیای واقعی را برطرف میکنند. مهمترین این حوزهها عبارتند از:
۱. ترجمه ماشینی (Machine Translation) : تلاش برای ترجمه خودکار متن و گفتار بین زبانهای مختلف
۲. تقاطع زبان و بینایی ماشین (Vision-Language) : ارتباط میان تصویر و متن که شامل زیرشاخههای زیر است
- OCR تبدیل تصاویر و دست نویس متنی به متن تایپی
- زیرنویسگذاری تصویر (Image Captioning): تولید خودکار توضیح متنی برای تصاویر.
- تولید تصویر از متن (Text-to-Image): ساخت تصاویر خلاقانه بر اساس توصیف متنی
۳. تحلیل احساسات و نظرکاوی (Sentiment Analysis) : استخراج احساسات، نظرات و عواطفِ نهفته در متنها. این ابزار کاربرد وسیعی در پایش برند، تحلیل بازخورد مشتریان در فروشگاههای آنلاین و تحلیل رفتارهای اجتماعی دارد.
۴. خلاصهسازی خودکار (Text Summarization) کوتاه کردن متون طولانی به دو روش:
- استخراجی (Extractive): بریدن و کنار هم قرار دادن جملات کلیدی متن اصلی.
- انتزاعی (Abstractive): درک مفاهیم و بازنویسی کل متن با ادبیات جدید (مشابه رفتار انسان).
۵. سیستمهای پرسش و پاسخ (Question Answering) : توسعه سیستمهایی که میتوانند به سوالات کاربران پاسخ دقیق دهند؛ از جستجو در پایگاههای داده گرفته تا چتباتهای زاینده (مانند ChatGPT) که پاسخهای طبیعی تولید میکنند.
۶. تشخیص موجودیتهای نامدار (NER) : شناسایی و دستهبندی خودکار کلمات خاص در متن مانند نام افراد، سازمانها، تاریخها، و یا در بخشهای تخصصیتر مانند نام داروها و بیماریها در پروندههای پزشکی.
۷. پردازش گفتار و صدا (Speech Processing): نقطه تلاقی سیگنالهای صوتی و متن که دو کاربرد اصلی تبدیل گفتار به متن (ASR) و تبدیل متن به گفتار (TTS) را دارد.
۸. تحلیل گفتمان و سیستمهای مکالمهای (Chatbots) : پژوهش روی ساخت چتباتهای هوشمند و تحلیل جریان گفتگوهای طولانی برای پشتیبانی مشتریان، مشاورههای تخصصی و درک ساختار روایی متون.
۹. طبقهبندی متن و کشف اطلاعات غلط (Text Classification) : دستهبندی خودکار اسناد (مانند فیلتر کردن ایمیلهای اسپم) و تحلیل محتوا برای شناسایی اخبار جعلی ، شایعات و متون سوگیرانه در بستر وب.
۱۰. بازیابی اطلاعات و جستجوی معنایی (Semantic Search) : عبور از جستجوی کلمهبهکلمه و حرکت به سمت درک «مفهوم و قصد کاربر» برای پیدا کردن دقیقترین نتایج متنی، تصویری یا صوتی.
۱۱. کاربردهای تخصصی (پزشکی و حقوقی) : کارگیری ابزارهای متنی برای تحلیل پروندههای قضایی و متون قانونی (Legal NLP) یا استخراج اطلاعات حیاتی از پروندههای بالینی و گزارشهای پزشکی (Clinical NLP) جهت کمک به تصمیمگیری متخصصان.
جمعبندی؛ از قواعد خشک تا فهم مبتنی بر داده
تاریخچه NLP، تاریخ تحول نگاه ما به زبان و هوش ماشینی است؛ از عصر قواعد دستنویس و نمادگرایی (که تصور میشد با قواعد کافی ماشین زبان را میفهمد)، به عصر آماری (که داده و احتمال درک زبان را مؤثرتر کردند) و سپس عصر یادگیری عمیق و مدلهای بزرگ زبانی (که به سطحی از عملکرد خیالانگیز رسیدند). این مسیر همچنان ادامه دارد و NLP به سمت تعامل طبیعیتر، فهم عمیقتر، شخصیسازی بیشتر و تلفیق با تصویر، صدا و دانش جهان حرکت میکند تا به رؤیای تورینگ نزدیکتر شود.