شناسایی و مدیریت دادههای پرت

شناسایی و مدیریت دادههای پرت (Outliers)
دادههای پرت یا Outliers به نمونههایی گفته میشود که نسبت به الگوی غالب دادهها فاصله قابلتوجهی دارند. این نقاط ممکن است به دلیل خطای اندازهگیری، ثبت نادرست اطلاعات، نویز، یا وقوع یک رخداد نادر اما مهم ایجاد شوند. وجود دادههای پرت میتواند میانگین، واریانس، ضرایب مدل و مرزهای تصمیمگیری را تغییر دهد و در صورت مدیریت نادرست، باعث کاهش دقت مدل و افزایش بیشبرازش (Overfitting) شود.
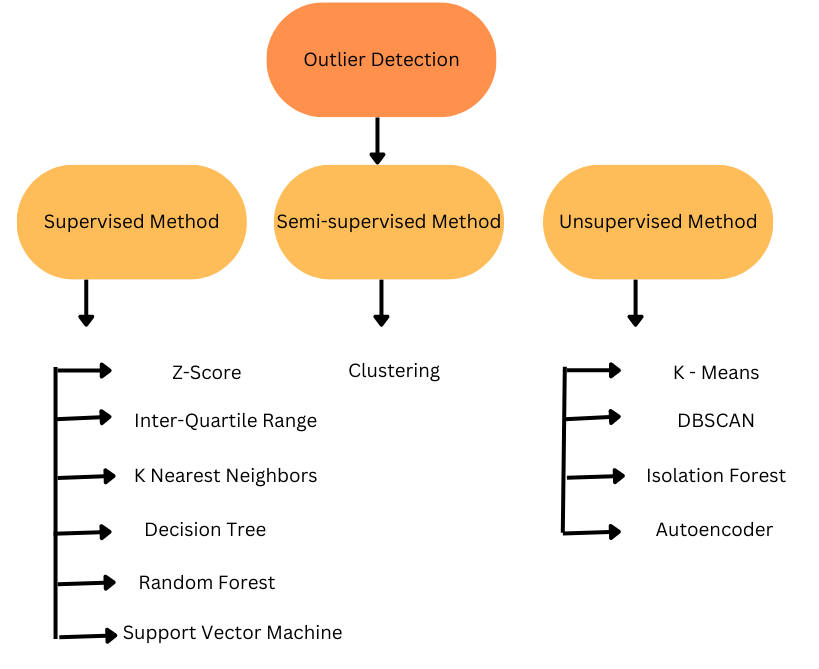
روشهای شناسایی دادههای پرت معمولاً در سه گروه کلی قرار میگیرند: روشهای بانظارت، نیمهنظارتی و بدوننظارت. در روشهای بانظارت، مدل با دادههای برچسبدار آموزش میبیند و تفاوت بین دادههای نرمال و پرت را یاد میگیرد. در روشهای نیمهنظارتی، مدل بیشتر با دادههای نرمال آموزش داده میشود و نمونههایی را که با الگوی عادی تفاوت دارند، پرت تشخیص میدهد. در روشهای بدوننظارت، نیازی به برچسبگذاری دادهها نیست و بر اساس فاصله، چگالی، خوشهبندی یا خطای بازسازی، دادههای غیرعادی را شناسایی میکنند. در ادامه به تشریح روش های شناسایی داده های پرت می پردازیم .
۱. تحلیل بصری با نمودار جعبهای (Box Plot)
یکی از سادهترین روشهای شناسایی اولیه دادههای پرت، استفاده از نمودار جعبهای یا Box Plot است. این نمودار توزیع داده را با استفاده از پنج شاخص اصلی نمایش میدهد:
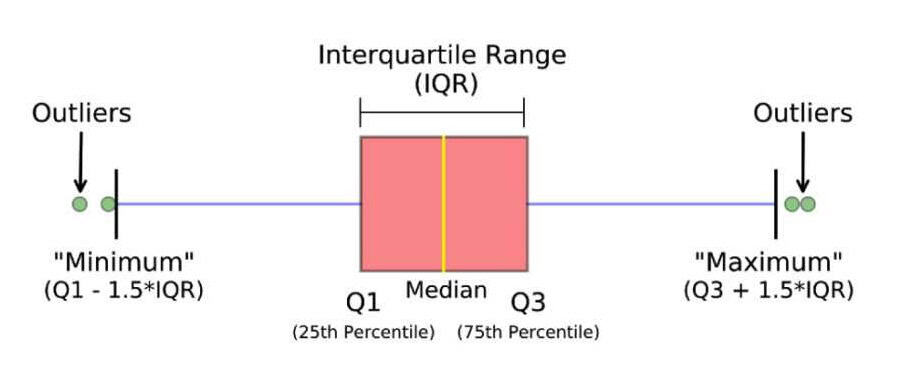
حداکثر مقدار ، چارک سومQ3 ، میانهQ2 ، چارک اولQ1 ، حداقل مقدار
در این نمودار، بخش جعبه بینQ1 وQ3 قرار دارد و میانه درون آن نمایش داده میشود. فاصله بین چارک سوم و اول را دامنه میانچارکی یا IQR مینامند:
معمولاً نقاطی که خارج از بازه زیر قرار بگیرند، به عنوان داده پرت در نظر گرفته میشوند:
اگر فاصله نقطه از چارکها بیشتر باشد، مثلاً از ضریب3×IQR استفاده شود، میتوان آن را داده پرت شدید در نظر گرفت. مزیت Box Plot این است که علاوه بر تشخیص نقاط پرت، اطلاعاتی درباره پراکندگی، چولگی و تمرکز دادهها نیز ارائه میدهد.
۲. روشهای آماری (Statistical Methods)
روش Z-Score
در روش Z-Score، فاصله هر داده از میانگین بر حسب انحراف معیار اندازهگیری میشود. فرمول آن به صورت زیر است:
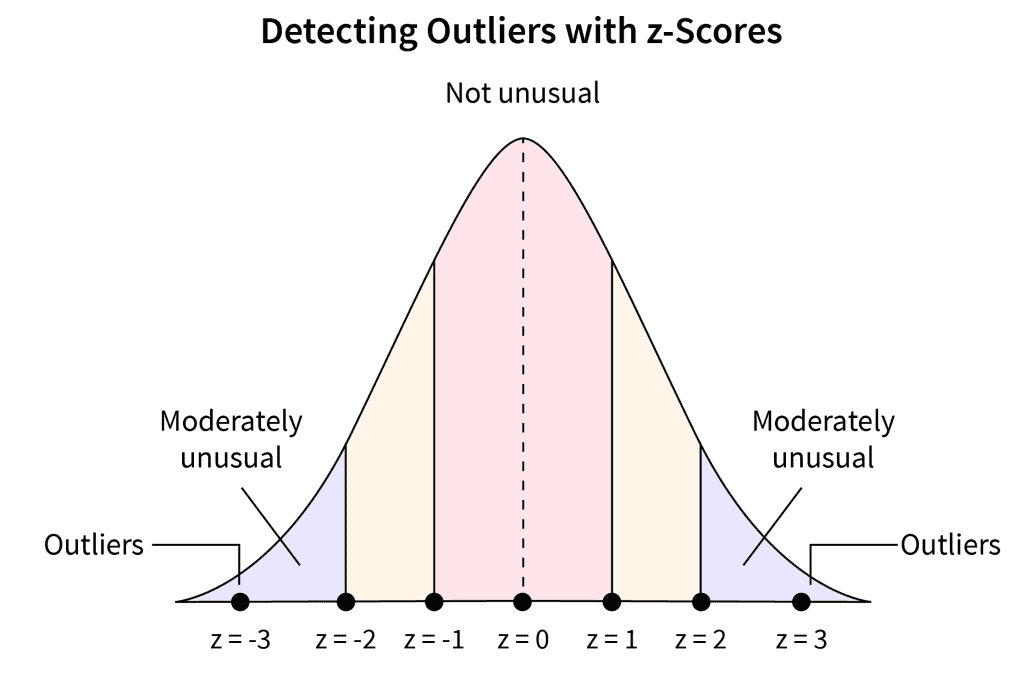
- xi: مقدار نمونه و μ: میانگین دادهها و σ: انحراف معیار
اگر مقدار∣Zi∣ از یک آستانه مشخص، معمولاً 3، بیشتر باشد، داده موردنظر به عنوان داده پرت شناخته میشود.
این روش زمانی مناسب است که دادهها توزیع نرمال یا نزدیک به نرمال داشته باشند. اگر توزیع داده چوله باشد یا خود دادههای پرت روی میانگین و انحراف معیار اثر بگذارند، دقت این روش کاهش مییابد.
روش IQR
روش IQR نسبت به Z-Score مقاومتر است، زیرا به جای میانگین و انحراف معیار، از چارکها استفاده میکند. به همین دلیل در دادههای واقعی و غیرنرمال معمولاً قابلاعتمادتر است. دادههایی که خارج از بازه زیر باشند پرت محسوب میشوند:
۳. روشهای مبتنی بر نزدیکی و چگالی
در این دسته از روشها (Proximity & Density-Based Methods)، ساختار محلی دادهها بررسی میشود. ایده اصلی این است که اگر یک نمونه نسبت به همسایگانش فاصله زیادی داشته باشد یا در ناحیهای با چگالی کم قرار گرفته باشد، احتمالاً داده پرت است.
K نزدیک ترین همسایگی (KNN)
در روش KNN-Based Outlier Detection، برای هر نقطه فاصله آن تا K همسایه نزدیکش محاسبه میشود. اگر این فاصله به طور غیرعادی زیاد باشد، آن نقطه پرت تلقی میشود. به طور ساده، امتیاز پرتی میتواند میانگین فاصله تا K همسایه نزدیک باشد:
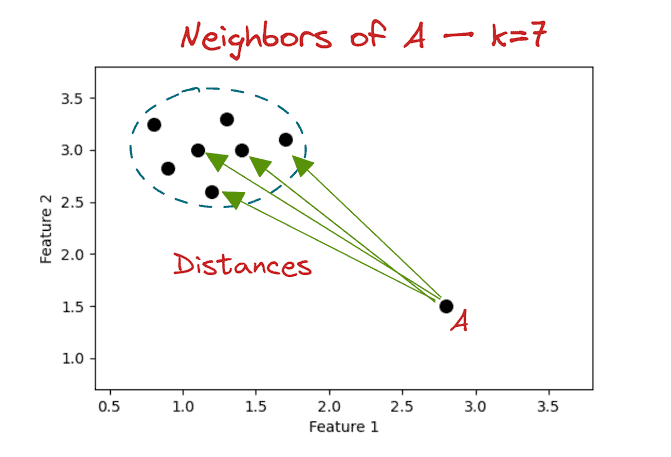
که در آن d(xi,xj) فاصله اقلیدسی یا هر معیار فاصله دیگر است. این روش در دادههای کمبعد مؤثر است، اما در ابعاد بالا به دلیل پدیده نفرین ابعاد کارایی آن کاهش مییابد.
Local Outlier Factor (LOF)
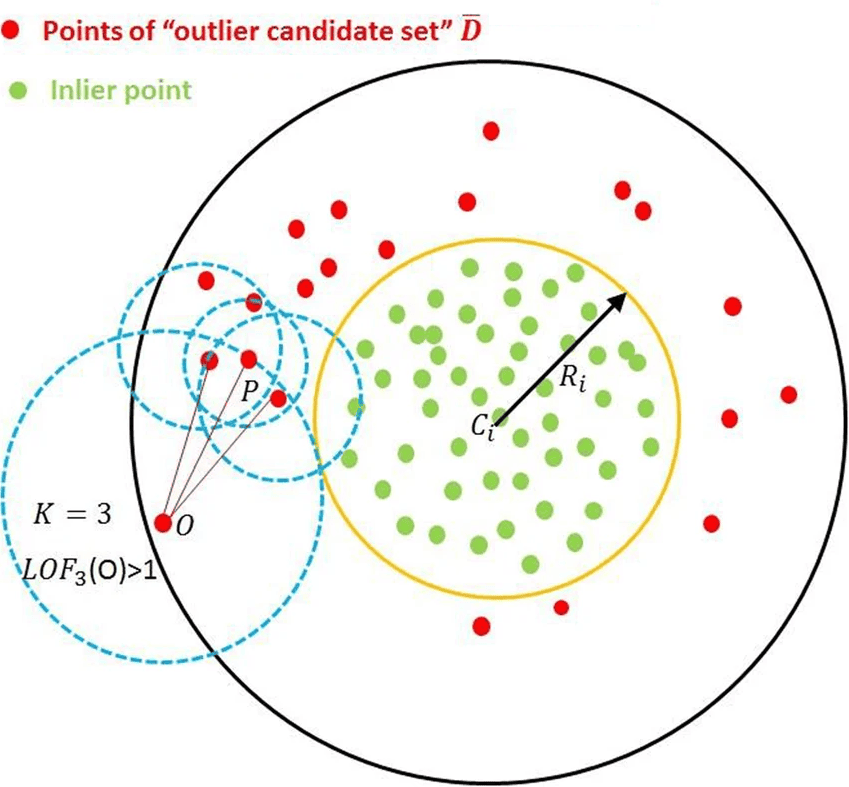
الگوریتم LOF یکی از روشهای مهم مبتنی بر چگالی است. این روش چگالی محلی یک نقطه را با چگالی همسایگانش مقایسه میکند. اگر چگالی محلی یک نقطه به شکل محسوسی کمتر از همسایگانش باشد، آن نقطه پرت در نظر گرفته میشود. فرمول کلی LOF به صورت مفهومی چنین است:
اگر مقدار LOF نزدیک 1 باشد، نقطه نرمال است. اگر مقدار آن بهطور قابلتوجهی بزرگتر از 1 باشد، احتمال پرت بودن افزایش مییابد.
۴. روشهای مبتنی بر خوشهبندی (Clustering-Based Methods)
در روشهای خوشهبندی، ابتدا ساختار گروهی دادهها استخراج میشود. سپس نقاطی که به خوشههای اصلی تعلق ندارند یا در خوشههای کوچک و پراکنده قرار دارند، بهعنوان داده پرت شناسایی میشوند.
DBSCAN
الگوریتم DBSCAN بر اساس چگالی کار میکند و دو پارامتر اصلی دارد
- : شعاع همسایگی
- MinPts: حداقل تعداد نقاط برای تشکیل ناحیه چگال
اگر تعداد نقاط داخل همسایگی برای یک نمونه کمتر از باشد، آن نقطه ممکن است نویز یا داده پرت در نظر گرفته شود. مزیت DBSCAN این است که نیازی به تعیین تعداد خوشهها از قبل ندارد و میتواند خوشههایی با شکلهای نامنظم را نیز شناسایی کند.
CBLOF
در روش Cluster-Based Local Outlier Factor (CBLOF)، ابتدا دادهها خوشهبندی میشوند. سپس دادههایی که در خوشههای کوچک قرار دارند یا فاصله زیادی با مراکز خوشههای بزرگ دارند، امتیاز پرتی بیشتری میگیرند. این روش ترکیبی از اطلاعات اندازه خوشه و فاصله تا خوشههای اصلی را استفاده میکند.
۵. روشهای مبتنی بر یادگیری ماشین (ML-Based Methods)
Isolation Forest
الگوریتم Isolation Forest بر این ایده استوار است که دادههای پرت نسبت به دادههای عادی سریعتر و با تعداد تقسیمات کمتری از سایر نقاط جدا میشوند. در این روش، با ساخت درختهای تصادفی، طول مسیر هر نمونه تا گره نهایی اندازهگیری میشود. اگر میانگین طول مسیر یک نقطه کوتاه باشد، احتمالاً آن نقطه پرت است. بهطور مفهومی:
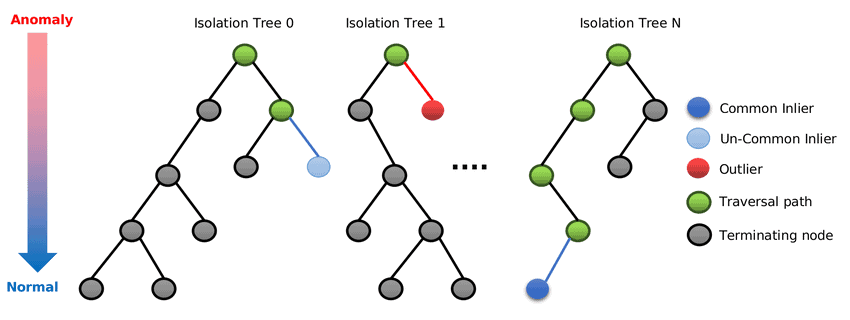
که در آن : امید ریاضی طول مسیر نمونه و : مقدار نرمالسازی برای تعداد نمونهها می باشد. غگر امتیاز به 1 نزدیک باشد، احتمال پرت بودن نقطه بیشتر است.
PCA-Based Outlier Detection
در روش تحلیل مؤلفههای اصلی (PCA)، دادهها به فضای کمبعدی نگاشت میشوند. سپس نقاطی که خطای بازسازی بالایی داشته باشند، داده پرت در نظر گرفته میشوند. اگر بازسازی نمونه باشد، خطای بازسازی به صورت زیر تعریف میشود:
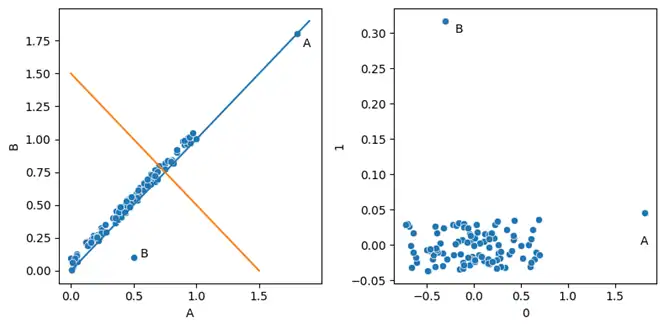
اگر این خطا زیاد باشد، نمونه موردنظر احتمالاً با ساختار اصلی دادهها سازگار نیست.
MCD
روش Minimum Covariance Determinant (MCD) برای تخمین مقاوم میانگین و کوواریانس استفاده میشود. سپس فاصله ماهالانوبیس برای هر نمونه محاسبه میشود:
که در آن بردار میانگین مقاوم و : ماتریس کوواریانس مقاوم می باشد. نقاطی که فاصله ماهالانوبیس بزرگی دارند، به عنوان پرت شناخته میشوند.
۶. روشهای پیشرفته: خودرمزگذارها و مدلهای ترکیبی
Autoencoders
خودرمزگذارها شبکههای عصبیای هستند که داده را ابتدا فشرده کرده و سپس بازسازی میکنند. اگر یک نمونه به خوبی بازسازی نشود، یعنی با الگوی غالب دادهها تطابق نداشته باشد، میتواند داده پرت باشد. معیار اصلی در این روش، خطای بازسازی است:
هرچه این خطا بیشتر باشد، احتمال پرت بودن نمونه افزایش مییابد.
Hybrid Methods
روشهای ترکیبی تلاش میکنند مزایای چند رویکرد مختلف را با هم ترکیب کنند. برای مثال، برخی مدلها ابتدا با روشهای نظارتنشده یک نمایش مناسب از داده یاد میگیرند و سپس از مدلهای نظارتشده برای تصمیمگیری نهایی استفاده میکنند. این روشها معمولاً در دادههای پیچیده، چندوجهی و پرابعاد عملکرد بهتری دارند.
استراتژی نهایی برای مدیریت دادههای پرت
پس از شناسایی دادههای پرت، تصمیمگیری درباره نحوه برخورد با آنها بسیار مهم است. این تصمیم باید بر اساس ماهیت مسئله، نوع داده و هدف تحلیل انجام شود.
۱. حذف دادههای پرت گر مشخص باشد که داده پرت ناشی از خطای قطعی در اندازهگیری، ورود اشتباه داده یا خرابی حسگر است، حذف آن مناسبترین گزینه است.
۲. جایگزینی دادههای پرت اگر حذف دادهها باعث کاهش بیش از حد حجم نمونه شود، میتوان بهجای حذف، دادههای پرت را با مقادیری مانند میانه، صدکها یا مقادیر تخمینی منطقی جایگزین کرد.
۳. نگهداری و تحلیل جداگانه در برخی مسائل، دادههای پرت در واقع مهمترین بخش داده هستند. برای مثال در تشخیص آریتمی قلبی، کشف تقلب، نشت گاز، خرابی ماشینآلات یا تشخیص بیماری، همین نقاط غیرعادی حامل ارزشمندترین اطلاعاتاند. در چنین شرایطی، حذف داده پرت اشتباه است و بهتر است بهعنوان یک کلاس مستقل یا رخداد نادر مورد تحلیل قرار گیرد.
تفاوت Outlier Detection و Anomaly Detection
در بسیاری از منابع، Outlier Detection و Anomaly Detection بهجای هم استفاده میشوند، اما تفاوت ظریفی دارند. Outlier Detection بیشتر روی شناسایی دادههایی تمرکز دارد که از الگوی کلی فاصله زیادی دارند، در حالیکه Anomaly Detection مفهوم گستردهتری است و هر نوع رفتار، رخداد یا الگوی غیرعادی را شامل میشود.
ه بیان ساده، Outlier Detection معمولاً زیرمجموعهای از Anomaly Detection است؛ یعنی هر داده پرت میتواند ناهنجاری باشد، اما هر ناهنجاری الزاماً یک نقطه پرت نیست. بسیاری از الگوریتمها در هر دو حوزه مشترکاند و تفاوت اصلی بیشتر در هدف تحلیل و نحوه تفسیر نتایج است.به طور خلاصه
- روشهای ساده مثل Z-Score، IQR و Box Plot بیشتر برای تشخیص داده پرت نقطهای مناسباند.
- روشهایی مثل Isolation Forest، LOF، DBSCAN، PCA و Autoencoder هم در هر دو حوزه استفاده میشوند.
- برای Anomaly Detection در دادههای زمانی، معمولاً روشهایی مثل LSTM Autoencoder، مدلهای پیشبینی سری زمانی، Prophet، ARIMA یا Transformer-based models هم استفاده میشوند.
جمعبندی
شناسایی دادههای پرت یکی از مراحل مهم در پیشپردازش داده و تحلیل هوشمند است. هیچ روش واحدی برای همه مسائل بهترین نیست. در دادههای ساده، روشهای آماری مانند Z-Score و IQR کافی هستند. در دادههای پیچیدهتر، روشهای مبتنی بر چگالی، خوشهبندی، یادگیری ماشین و شبکههای عصبی عملکرد بهتری دارند. انتخاب روش مناسب باید با توجه به ساختار داده، ابعاد مسئله، توزیع دادهها و هدف نهایی تحلیل انجام شود. در عمل، ترکیب تحلیل بصری، روشهای آماری و الگوریتمهای هوشمند بهترین نتیجه را در شناسایی دقیق دادههای پرت فراهم میکند.
| روش | نوع روش | ایده اصلی | مزایا | محدودیتها |
|---|---|---|---|---|
| Box Plot | آماری / بصری | تشخیص نقاط خارج از محدوده | ساده، سریع، قابل درک | فقط برای دادههای تکبعدی مناسب است |
| Z‑Score | آماری | اندازهگیری فاصله هر داده از میانگین بر حسب انحراف معیار | محاسبه سریع و ساده | حساس به توزیع غیرنرمال و خود دادههای پرت |
| IQR | آماری مقاوم | استفاده از چارکها برای شناسایی نقاط خارج از دامنه میانچارکی | مقاوم در برابر دادههای پرت | برای دادههای چندبعدی محدود است |
| KNN | مبتنی بر فاصله | بررسی فاصله هر نقطه تا K همسایه نزدیک | قابل فهم و بدون فرض توزیع | در دادههای پرابعاد و بزرگ کند است |
| LOF | مبتنی بر چگالی | مقایسه چگالی محلی هر نقطه با همسایگان | مناسب برای ساختارهای پیچیده | حساس به انتخاب پارامترها |
| DBSCAN | خوشهبندی چگالیمحور | نقاطی که در خوشه قرار نمیگیرند نویز محسوب میشوند | تشخیص خوشههای با شکل نامنظم | حساس به پارامتر ε و MinPts |
| Isolation Forest | یادگیری ماشین | ایزوله شدن سریعتر دادههای پرت در درختها | سریع و مناسب دادههای بزرگ | در ناهنجاریهای پیچیده محدود |
| PCA | کاهش ابعاد | تشخیص نقاط با خطای بازسازی بالا | مناسب برای دادههای چندبعدی | فرض خطی بودن داده |
| Autoencoder | یادگیری عمیق | تشخیص نقاط با خطای بازسازی بالا در شبکه عصبی | مناسب دادههای پیچیده و پرابعاد | نیاز به داده زیاد و آموزش مدل |