تقویت داده (Data Augmentation) در بینایی ماشین:
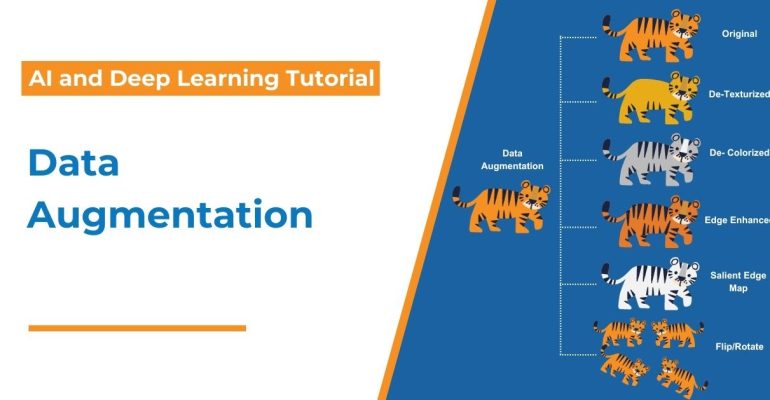

دادهافزایی یا تقویت داده یکی از مؤثرترین و کمهزینهترین تکنیکهای منظمسازی (Regularization) در یادگیری عمیق بینایی ماشین (Computer Vision) است که مستقیماً تعمیمپذیری (Generalization)و استحکام مدل (Robustness) را بهبود میدهد. بدون داده افزایی مناسب، حتی قویترین معماریها (ResNet، EfficientNet، ViT، ConvNeXt، YOLOv8–v10 و…) به شدت در معرض بیشبرازش و افت عملکرد در شرایط واقعی قرار میگیرند.
چرا تقویت داده ضروری است؟
ظرفیت بالای شبکههای عمیق امروزی باعث میشود روی دادههای محدود و «تمیز» به سرعت بیشبرازش کنند. در دنیای واقعی، تصاویر با تغییرات نور، زاویه، انسداد، نویز و مقیاس مواجه هستند. دادهافزایی این تغییرات را به صورت کنترلشده در فرآیند آموزش شبیهسازی میکند و مدل را مجبور میکند ویژگیهای پایدار (invariant) و تبدیلپذیر (equivariant) را یاد بگیرد.

انواع اصلی تکنیکهای تقویت داده
- تبدیلهای هندسی (Geometric Transformations)

- چرخش (Rotation): ±۱۵ تا ±۴۵ درجه (بسته به حوزهٔ مسئله)
- ترجمه یا جابهجایی (Translation / Shift)
- مقیاسگذاری (Scale / Zoom In-Out)
- برش تصادفی (Random Crop) و تغییر اندازه به ابعاد ثابت
- آینهای کردن افقی و عمودی (Horizontal & Vertical Flip)
- برش پرسپکتیو و افاین (Affine & Perspective Transform)
- کشیدگی و فشردگی (Shear)
- الاستیک (Elastic Transformations – شبیهسازی تغییر شکل بافت پوست یا پارچه)
2. تبدیلهای فتومتریک و رنگی (Photometric / Color Transformations)

- تغییر روشنایی (Brightness)
- تغییر کنتراست (Contrast)
- تغییر اشباع رنگ (Saturation)
- تغییر تهرنگ (Hue)
- تبدیل به خاکستری و دوباره رنگی کردن (Grayscale → Color Jitter)
- AutoContrast، Equalize، Posterize
- Solarize و Invert
3. افزودن نویز (Noise Injection)

- نویز گوسی (Gaussian Noise)
- نویز نمک و فلفل (Salt & Pepper)
- نویز اسپکل (Speckle Noise)
- تاری حرکت (Motion Blur)
- تاری گوسی (Gaussian Blur) با شدت کم
4. تکنیکهای پاککردن بخشی از تصویر (Erasing / Occlusion)

- CutOut و Random Erasing: حذف تصادفی مستطیلهایی از تصویر
- GridMask: حذف منظم شبکهای از پیکسلها
- Hide-and-Seek: تقسیم تصویر به شبکه و حذف تصادفی برخی خانهها
5. روشهای ترکیبی در سطح نمونهها (Sample-Mixing Augmentations)

- MixUp: ترکیب خطی دو تصویر و برچسبهای آنها (α-Beta distribution)
- CutMix: بریدن بخشی از یک تصویر و چسباندن روی تصویر دیگر + ترکیب برچسبها
- Mosaic (در YOLO): ترکیب ۴ تصویر در یک تصویر (بسیار مؤثر در تشخیص اشیاء کوچک)
- AutoAugment، RandAugment، AugMix: جستجوی خودکار بهترین سیاستهای افزایش داده
6. تکنیکهای پیشرفته و جدید (۲۰۲۲-۲۰۲۵)
- TrivialAugment: انتخاب تصادفی یک تبدیل با شدت تصادفی (ساده اما بسیار مؤثر)
- AugMix: ترکیب چندین زنجیرهٔ تقویت داده با ترکیب Jensen-Shannon Divergence
- CutBlur: ترکیب نسخهٔ فوقپیکسلی و معمولی تصویر
- TokenMix، Attentive CutMix (برای Vision Transformerها)
- استفاده از مدلهای مولد (GAN، Diffusion) برای تولید نمونههای جدید (Synthetic Data)

کتابخانههای محبوب پایتون برای پیادهسازی (۲۰۲۵)
- Albumentations (سریعترین و کاملترین برای PyTorch)
- torchvision.transforms (بهبودهای جدید در v2)
- ImgAug
- Kornia (کاملاً مبتنی بر GPU)
- AugLy (از متا)
- TensorFlow Image Augmentation Layers
نکات عملی برای پیادهسازی موفق
- در مسائل تشخیص شیء و بخش بندی، تقویت داده باید روی ماسکها و جعبه های مرزی هم اعمال شود ( کتابخانه های Albumentations و Kornia این کار را بهخوبی انجام میدهند).
- تقویت داده باید فقط روی مجموعهٔ آموزشی و به صورت on-the-fly انجام شود تا حجم مصرفی رم را کاهش دهد.
- درداده های اریابی و تست فقط Resize + CenterCrop + Normalize اعمال کنید مجاز به اعمال سایر روش های تقویت داده نیستید.
- شدت تقویت داده را متناسب با حجم دیتاست تنظیم کنید (در دیتاست کوچک → تقویت سنگینتر).
- برای Vision Transformerها معمولاً از RandAugment یا TrivialAugment با شدت متوسط استفاده میشود؛ تقویت خیلی شدید میتواند tokenهای positional را مختل کند.
- Test-Time Augmentation (TTA) معمولاً ۰.۵–۲ درصد بهبود دقت نهایی میدهد.
نتیجهگیری
تقویت داده دیگر یک «ترفند» نیست؛ بلکه بخش جداییناپذیر از معماریهای مدرن بینایی ماشین است. بدون یک طرح تقویت داده قوی و بهروز، حتی پیشرفتهترین مدلها (از ConvNeXtV2 گرفته تا CoCa یا Florence-2) نمیتوانند به حداکثر پتانسیل خود برسند. اغلب تأثیر تقویت داده بسیار بالاتر از تغییر معماری یا افزایش عمق مدل است و هزینهٔ محاسباتی بسیار کمی به همراه میآورد. این مساله تضمین می کند که مدل شما در محیط های واقعی (نور کم، زاویههای عجیب، تغییرات آبوهوایی) عملکرد خوبی داشته باشد.
یک تصویر تمیز ≠ دادهٔ کافی
صدها یا هزاران نسخهٔ هوشمندانه و کنترلشده از همان تصویر = مدلی قوی، مقاوم و آمادهٔ دنیای واقعی.