یادگیری ترکیبی (EL)


یادگیری ترکیبی (Ensemble Learning)
یادگیری ترکیبی یک تکنیک در یادگیری ماشین است که از ترکیب چندین مدل پایه (که میتوانند مدلهای ضعیف یا قوی باشند) برای بهبود دقت، پایداری و مقاومت در برابر خطاها استفاده میکند. به جای تکیه بر یک مدل واحد که ممکن است به دلیل بایاس (Bias)، واریانس (Variance) یا نویز (Noise) عملکرد ضعیفی داشته باشد، یادگیری ترکیبی با تجمیع پیشبینیهای چندین مدل، یک مدل نهایی قویتر ایجاد میکند. این روش با بهرهگیری از دیدگاههای مختلف مدلها، خطاها را کاهش داده و عملکرد کلی را بهبود میبخشد.
یادگیری ترکیبی شامل روشهای مختلفی است که هر کدام رویکرد خاص خود را برای ترکیب مدلها دارند.
چالشهای یادگیری ماشین و نقش یادگیری ترکیبی
یادگیری ماشین با سه چالش اصلی مواجه است:
- بایاس (Bias): خطایی که به دلیل سادهسازی بیش از حد مدل (Underfitting) ایجاد میشود. مثلاً، یک مدل خطی برای دادههای غیرخطی ممکن است بایاس بالایی داشته باشد.
- واریانس (Variance): حساسیت بیش از حد مدل به تغییرات کوچک در دادههای آموزشی (Overfitting). مثلاً، یک درخت تصمیم عمیق ممکن است واریانس بالایی داشته باشد.
- نویز (Noise): دادههای نادرست یا پرت (Outliers) که به دلیل خطاهای اندازهگیری یا جمعآوری داده ایجاد میشوند.
یادگیری گروهی با ترکیب مدلهای مختلف، این چالشها را به روشهای زیر مدیریت میکند:
- کاهش واریانس: با میانگینگیری یا رأیگیری از چندین مدل (مانند بگینگ)، اثر تغییرات تصادفی در دادهها کاهش مییابد.
- کاهش بایاس: با استفاده از روشهایی مانند بوستینگ، مدلهای ضعیف بهبود یافته و بایاس کاهش مییابد.
- مقاومت در برابر نویز: ترکیب پیشبینیهای چندین مدل باعث میشود تأثیر دادههای نویزی یا پرت کمتر شود.
روشهای اصلی یادگیری ترکیبی
1. بگینگ (Bootstrap Aggregating):

- نحوه کار: دادههای آموزشی به چندین زیرمجموعه تصادفی (با نمونهبرداری با جایگزینی) تقسیم میشوند. هر زیرمجموعه برای آموزش یک مدل پایه (مانند درخت تصمیم) استفاده میشود. پیشبینیهای نهایی با رأیگیری اکثریت (برای طبقهبندی) یا میانگینگیری (برای رگرسیون) ترکیب میشوند.
- مزیت اصلی: کاهش واریانس و مقاومت در برابر بیشبرازش (Overfitting).
- مثال: الگوریتم Random Forest که نسخه پیشرفته بگینگ است و علاوه بر نمونهبرداری تصادفی دادهها، ویژگیهای تصادفی را نیز انتخاب میکند.
2. بوستینگ (Boosting):

- نحوه کار: مدلها به صورت ترتیبی آموزش میبینند، به طوری که هر مدل جدید روی خطاهای مدل قبلی تمرکز میکند. دادههایی که به اشتباه پیشبینی شدهاند، وزن بیشتری میگیرند.
- مزیت اصلی: کاهش بایاس و بهبود دقت مدلهای ضعیف.
- مثال: الگوریتمهایی مانند AdaBoost، Gradient Boosting و XGBoost.
3. استکینگ (Stacking):

- نحوه کار: چندین مدل پایه (مانند درخت تصمیم، SVM، شبکه عصبی) آموزش داده میشوند و پیشبینیهای آنها به یک مدل سطح بالاتر (Meta-Learner) داده میشود تا پیشبینی نهایی را انجام دهد.
- مزیت اصلی: استفاده از نقاط قوت مدلهای مختلف.
4. رأیگیری (Voting):
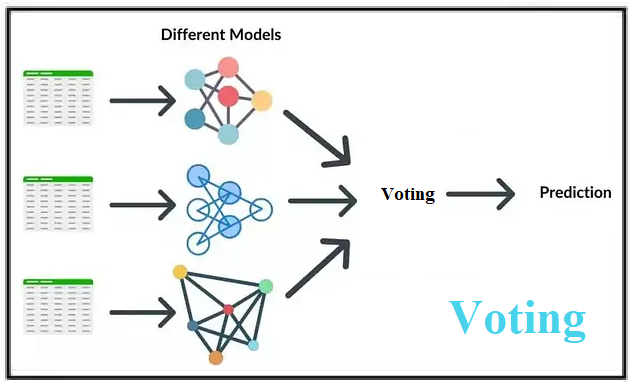
- نحوه کار: چندین مدل پایه (مانند درخت تصمیم، رگرسیون لجستیک، یا SVM) به طور مستقل روی کل دادههای آموزشی یا زیرمجموعههای آن آموزش میبینند. پیشبینی نهایی از طریق ترکیب ساده پیشبینیها انجام میشود. این روش به دو شکل اصلی است: رأیگیری سخت (Hard Voting) که کلاس با بیشترین رأی انتخاب میشود، و رأیگیری نرم (Soft Voting) که میانگین احتمالات پیشبینیها برای انتخاب کلاس نهایی استفاده میشود.
- مزیت اصلی: سادگی و بهبود دقت با ترکیب مدلهای متنوع، به ویژه در مسائل طبقهبندی.
مزایای یادگیری ترکیبی
- افزایش دقت پیشبینی: با ترکیب چندین مدل، یادگیری گروهی معمولاً دقت بالاتری نسبت به یک مدل واحد ارائه میدهد، بهویژه در دادههای پیچیده. مثلاً در تشخیص سرطان، ترکیب چندین مدل میتواند نرخ تشخیص مثبت کاذب را کاهش دهد.
- کاهش بیشبرازش (Overfitting): یادگیری گروهی با میانگینگیری یا انتخاب بهترین پیشبینیها، حساسیت به دادههای خاص یا نویز را کاهش میدهد. مثلاً Random Forest در مقایسه با یک درخت تصمیم عمیق کمتر بیشبرازش میکند.
- بهبود پایداری مدلها در برابر نویز: ترکیب مدلها باعث میشود نویز در دادههای آموزشی تأثیر کمتری بر پیشبینی نهایی داشته باشد. مثلاً در پیشبینی قیمت سهام که دادهها نویزی هستند، بگینگ میتواند پیشبینیهای پایدارتری ارائه دهد.
- استفاده از چند دید مختلف نسبت به دادهها: یادگیری گروهی امکان استفاده از مدلهای متنوع (مانند ترکیب درخت تصمیم و SVM در استکینگ) را فراهم میکند، که باعث میشود جنبههای مختلف دادهها بررسی شود. مثلاً در تحلیل احساسات متنی، ترکیب مدلهای مبتنی بر لغات و شبکههای عصبی میتواند نتایج بهتری بدهد.
- انعطافپذیری در مدلهای پایه: یادگیری گروهی میتواند با هر نوع مدل پایه (خطی، غیرخطی، ساده یا پیچیده) کار کند. مثلاً در مسائل رگرسیون، میتوان از ترکیب رگرسیون خطی و درخت تصمیم استفاده کرد.
- موازیسازی: در روشهایی مانند بگینگ، مدلها میتوانند به صورت موازی آموزش ببینند، که سرعت پردازش را افزایش میدهد. مثلاً آموزش Random Forest روی دادههای بزرگ با استفاده از چند هسته پردازشی.
معایب یادگیری ترکیبی
- پیچیدگی محاسباتی: آموزش چندین مدل نیاز به منابع محاسباتی بیشتری (زمان و حافظه) دارد. مثلاً آموزش XGBoost روی دادههای بزرگ میتواند زمانبر باشد.
- کاهش تفسیرپذیری: مدلهای گروهی (مانند Random Forest یا استکینگ) معمولاً پیچیدهتر از مدلهای تک هستند و تفسیر آنها دشوار است. مثلاً درک اینکه چرا یک مدل گروهی یک پیشبینی خاص انجام داده، سختتر از یک رگرسیون خطی است.
- حساسیت به تنظیم پارامترها: در برخی روشها (مانند بوستینگ)، تنظیم پارامترهایی مانند نرخ یادگیری یا تعداد مدلها حیاتی است و نیاز به تجربه دارد. مثلاً در Gradient Boosting، انتخاب نادرست نرخ یادگیری میتواند به عملکرد ضعیف منجر شود.
- عدم تأثیر در دادههای خیلی کوچک: اگر مجموعه داده کوچک باشد، زیرمجموعههای ایجادشده تفاوت زیادی با هم ندارند و فایده یادگیری گروهی کاهش مییابد. مثلاً در مجموعه داده با ۱۰۰ نمونه، بگینگ ممکن است تأثیر کمی داشته باشد.
- عدم کاهش بایاس در برخی روشها: روشهایی مانند بگینگ روی کاهش بایاس تأثیر زیادی ندارند و برای مدلهای با بایاس بالا نیاز به روشهای مکمل مانند بوستینگ است.
مقایسه روشهای یادگیری ترکیبی
برای مقایسه دقیق، این روشها را از جنبههای مختلف بررسی میکنیم:
| معیار | بگینگ (Bagging) | بوستینگ (Boosting) | استکینگ (Stacking) | رأیگیری (Voting) |
|---|---|---|---|---|
| نحوه آموزش مدلها | موازی: هر مدل به طور مستقل روی زیرمجموعهای از دادهها آموزش میبیند. | ترتیبی: هر مدل روی خطاهای مدل قبلی تمرکز میکند و دادهها وزندهی میشوند. | ترکیبی: مدلهای پایه به صورت موازی آموزش میبینند، سپس یک مدل سطح بالاتر آموزش داده میشود. | موازی: مدلها به طور مستقل آموزش میبینند، بدون وابستگی به یکدیگر. |
| هدف اصلی | کاهش واریانس (Variance) و بهبود پایداری در برابر نویز و بیشبرازش (Overfitting). | کاهش بایاس (Bias) و واریانس، با تمرکز بر بهبود مدلهای ضعیف. | ترکیب نقاط قوت مدلهای متنوع برای حداکثر کردن دقت. | کاهش واریانس با ترکیب ساده پیشبینیهای مدلهای متنوع. |
| ترکیب پیشبینیها | رأیگیری اکثریت (طبقهبندی) یا میانگینگیری (رگرسیون). | وزندهی به پیشبینیها بر اساس عملکرد مدلها (معمولاً با وزنهای پویا). | استفاده از یک مدل سطح بالاتر (مانند رگرسیون لجستیک یا شبکه عصبی) برای ترکیب پیشبینیها. | رأیگیری سخت (اکثریت) یا نرم (میانگین احتمالات). |
| پیچیدگی محاسباتی | متوسط: آموزش موازی باعث سرعت بالاتر میشود، اما تعداد مدلها میتواند زیاد باشد. | بالا: آموزش ترتیبی و وزندهی دادهها زمانبر است. | بالا: نیاز به آموزش مدلهای پایه متنوع و سپس مدل سطح بالاتر. | پایین: ساده و سریع، بدون نیاز به مدل سطح بالاتر. |
| تفسیرپذیری | کم: بهویژه در الگوریتمهایی مانند Random Forest، تفسیر دشوار است. | خیلی کم: مدلهای ترتیبی پیچیدهتر هستند و تفسیر آنها سختتر است. | خیلی کم: به دلیل ترکیب مدلهای متنوع، تفسیر نتایج دشوار است. | متوسط: سادهتر از استکینگ، اما همچنان پیچیدهتر از مدل تک. |
| مقاومت در برابر نویز | بالا: به دلیل میانگینگیری، نویز تأثیر کمتری دارد. | متوسط: اگر نویز زیاد باشد، ممکن است مدل روی دادههای نویزی بیشبرازش کند. | بالا: ترکیب مدلهای متنوع میتواند نویز را بهتر مدیریت کند. | خوب: ترکیب مدلها نویز را کاهش میدهد، اما کمتر از بگینگ. |
| کاهش بیشبرازش | عالی: به دلیل استفاده از زیرمجموعههای تصادفی، بیشبرازش کاهش مییابد. | متوسط: اگر تنظیمات نادرست باشد، ممکن است بیشبرازش رخ دهد. | خوب: به شرط انتخاب مدلهای پایه مناسب و تنظیم مدل سطح بالاتر. | خوب: ترکیب مدلها بیشبرازش را کنترل میکند، اما وابسته به مدلهای پایه. |
| نوع دادههای مناسب | دادههای نویزی، چندبعدی، بزرگ، و نامتوازن. | دادههایی با بایاس بالا، دادههای نسبتاً تمیز، و مسائل پیچیده. | دادههای پیچیده که مدلهای متنوع میتوانند جنبههای مختلف آن را پوشش دهند. | دادههای طبقهبندی با مدلهای متنوع و دادههای نسبتاً تمیز. |
| مزایا | – کاهش واریانس – موازیسازی آسان – مقاومت در برابر نویز – پیادهسازی ساده | – کاهش بایاس و واریانس – دقت بالا در مسائل پیچیده – بهبود مدلهای ضعیف | – استفاده از نقاط قوت مدلهای مختلف – انعطافپذیری بالا – دقت بسیار بالا | – سادگی و سرعت – بهبود دقت با ترکیب مدلهای متنوع – مقاومت در برابر نویز |
| معایب | – عدم کاهش بایاس – مصرف حافظه بالا – کمتر مؤثر در دادههای کوچک | – خطر بیشبرازش – پیچیدگی محاسباتی بالا – حساسیت به نویز | – پیچیدگی زیاد – نیاز به تنظیم دقیق – زمانبر بودن آموزش | – عدم وزندهی پیچیده – بهبود محدود اگر مدلهای پایه ضعیف باشند |
| مثال الگوریتم | Random Forest, Extra Trees | AdaBoost, Gradient Boosting, XGBoost, LightGBM, CatBoost | ترکیب مدلهای مختلف (مانند SVM + Random Forest + Neural Network) | VotingClassifier |
تفاوتهای کلیدی در روشها
- تفاوت در هدف: بگینگ روی کاهش واریانس تمرکز دارد، بنابراین برای مدلهای ناپایدار (مانند درختهای تصمیم عمیق) که به تغییرات کوچک در داده حساساند، مناسب است. بوستینگ روی کاهش بایاس و بهبود مدلهای ضعیف تمرکز دارد، بنابراین برای مسائل پیچیده که مدلهای پایه عملکرد ضعیفی دارند، بهتر عمل میکند. استکینگ هدفش حداکثر کردن دقت با ترکیب مدلهای متنوع است، بنابراین برای مسائل پیچیده با دادههای چندگانه مناسب است. رأیگیری روی ترکیب ساده پیشبینیها تمرکز دارد و برای مسائل طبقهبندی سادهتر با مدلهای متنوع مفید است.
- تفاوت در نوع دادهها: بگینگ برای دادههای نویزی، چندبعدی و بزرگ مناسب است، بهویژه اگر دادهها نامتوازن باشند (مثل تشخیص تقلب). بوستینگ برای دادههای نسبتاً تمیز و مسائل پیچیدهای که نیاز به مدلهای قوی دارند مناسب است، اما در دادههای خیلی نویزی ممکن است بیشبرازش کند. استکینگ برای دادههای پیچیده که مدلهای مختلف میتوانند جنبههای متفاوتی از آنها را پوشش دهند (مانند دادههای ترکیبی در مسابقات) مناسب است. رأیگیری برای دادههای طبقهبندی با مدلهای متنوع و دادههای نسبتاً تمیز مناسب است.
- پیچیدگی و زمان اجرا: بگینگ به دلیل موازی بودن، با سختافزار مناسب سریعتر است. بوستینگ به دلیل آموزش ترتیبی، زمانبرتر است و نیاز به تنظیم دقیق پارامترها دارد. استکینگ پیچیدهترین روش است، زیرا نیاز به آموزش مدلهای پایه متنوع و سپس مدل سطح بالاتر دارد. رأیگیری سادهترین و سریعترین روش است.
- مقاومت در برابر بیشبرازش: بگینگ به دلیل استفاده از زیرمجموعههای تصادفی، کمتر دچار بیشبرازش میشود. بوستینگ اگر تعداد دورهای آموزش (Iterations) زیاد باشد یا دادهها نویزی باشند، ممکن است بیشبرازش کند. استکینگ با تنظیم مناسب مدل سطح بالاتر، میتواند بیشبرازش را کنترل کند، اما نیاز به تجربه دارد. رأیگیری بیشبرازش را با ترکیب ساده کاهش میدهد، اما وابسته به کیفیت مدلهای پایه است.
موارد کاربرد یادگیری ترکیبی
یادگیری گروهی در حوزههای مختلف که نیاز به پیشبینی دقیق و پایدار دارند، کاربرد گستردهای دارد:
- پزشکی: تشخیص بیماریها (مانند سرطان یا دیابت) با دادههای نویزی یا نامتوازن.
- مالی: پیشبینی ریسک اعتباری، تشخیص تقلب در تراکنشها، یا پیشبینی قیمت سهام.
- پردازش تصویر و صوت: شناسایی اشیاء در تصاویر، تشخیص گفتار، یا تحلیل احساسات در ویدئوها.
- تحلیل دادههای متنی: طبقهبندی ایمیلها (اسپم/غیراسپم)، تحلیل احساسات، یا ترجمه ماشینی.
- علوم زیستی: تحلیل دادههای ژنومی برای پیشبینی بیماریها یا کشف دارو.
- مسابقات یادگیری ماشین: الگوریتمهای گروهی مانند XGBoost و Random Forest در پلتفرمهایی مانند Kaggle بسیار محبوب هستند.
جمعبندی
یادگیری ترکیبی با ترکیب چندین مدل، چالشهای اصلی یادگیری ماشین (بایاس، واریانس، و نویز) را مدیریت میکند. روشهایی مانند بگینگ، بوستینگ، استکینگ و رأیگیری هر کدام برای سناریوهای خاصی مناسب هستند. مزایای این روش شامل افزایش دقت، کاهش بیشبرازش، پایداری در برابر نویز، و انعطافپذیری است، اما معایبی مانند پیچیدگی محاسباتی و کاهش تفسیرپذیری نیز دارد. یادگیری گروهی در دادههای نویزی، چندبعدی، نامتوازن و بزرگ بهترین عملکرد را دارد و در حوزههایی مانند پزشکی، مالی، و پردازش تصویر کاربرد گستردهای دارد.