آموزش Numpy: بخش دوم


فصل دوم: محاسبات برداری، انتشار و توابع پیشرفته
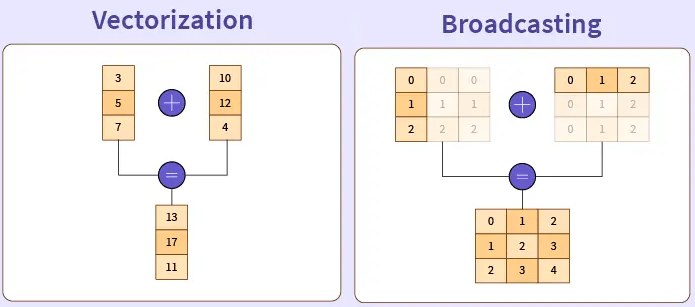
در پایتون معمولی، برای اعمال یک فرمول ریاضی روی تکتک عناصر یک لیست، مجبور به استفاده از حلقههای for بودیم. این کار علاوه بر کند کردن برنامه، کدنویسی را پیچیده میکرد. نامپای با دو مفهوم کلیدی بردارسازی (Vectorization) و قاعده انتشار (Broadcasting)، محاسبات ریاضی را بدون نیاز به حلقه و با سرعتی نزدیک به زبان C اجرا میکند. در این فصل، گامبهگام با ابزارهای تولید داده اولیه، عملیات حسابی، توابع آماری و لگاریتمی و در نهایت جبر خطی آشنا میشویم.
فهرست مطالب
۱. توابع ساخت و مقداردهی اولیه آرایهها
قبل از انجام هرگونه محاسبه، باید نحوه ساخت سریع آرایهها (Array Creation) و ماتریسهای اولیه را یاد بگیریم. نامپای توابع متنوعی برای تولید آرایههای پرشده با صفر، یک، مقادیر تصادفی یا دنبالههای منظم ارائه میدهد.
| نام تابع | کاربرد اصلی | توضیحات پارامترها |
|---|---|---|
np.zeros() | ساخت آرایهای پر از صفر | دریافت ابعاد (shape) به صورت تاپل یا عدد |
np.ones() | ساخت آرایهای پر از یک | دریافت ابعاد (shape) و تعیین نوع داده (dtype) |
np.full() | پر کردن تمام عناصر با یک مقدار دلخواه | دریافت ابعاد و مقدار ثابت (fill_value) |
arr.fill() | تغییر تمام عناصر یک آرایه موجود به مقداری خاص | اعمال مستقیم روی آرایه موجود (In-place) |
np.arange() | تولید دنباله عددی با گام مشخص | الگوی (start, stop, step) – عدم شامل شدن stop |
np.linspace() | تولید اعداد با فواصل برابر در یک بازه | الگوی (start, stop, num) – شامل شدن خود stop |
np.eye() | ساخت ماتریس همانی (Identity Matrix) | دریافت عدد n برای ساخت ماتریس n در n |
np.random.rand() | تولید اعداد تصادفی با توزیع یکنواخت | اعداد بین ۰ تا ۱ |
np.random.randn() | تولید اعداد تصادفی با توزیع نرمال استاندارد | میانگین ۰ و انحراف معیار ۱ |
np.random.randint() | تولید اعداد صحیح تصادفی | الگوی (low, high, size) |
الف) ساخت آرایه با صفر، یک و مقادیر ثابت
این توابع زمانی استفاده میشوند که میخواهیم حافظهای را برای محاسبات بعدی رزرو کنیم.
تابع np.zeros()
ساخت آرایهای که تمام درایههای آن از عدد ۰ پر شدهاند (مناسب برای ساخت ماتریسهای اولیه و پر کردن بعدی آنها).
import numpy as np
# ساخت ماتریس ۲ سطر و ۳ ستون پر از صفر (با نوع داده اعشاری پیشفرض)
zeros_matrix = np.zeros((2, 3))
print("ماتریس صفر:\n", zeros_matrix)
تابع np.ones()
ساخت آرایهای که تمام خانههای آن عدد ۱ هستند.
# ساخت بردار ۴ عضوی از عدد یک با نوع داده صحیح (int)
ones_arr = np.ones(4, dtype=int)

print(ones_arr)
# خروجی: [1 1 1 1]
# ساخت ماتریس ۲x۲ پر از عدد ۷
full_matrix = np.full((2, 2), 7)
print("\nماتریس پر شده با ۷:\n", full_matrix)

# مقداردهی مجدد تمام عناصر یک آرایه موجود با تابع fill
arr = np.array([10, 20, 30])
arr.fill(100)
print("\nآرایه پس از اجرای fill:", arr)
ب) تولید دنبالههای منظم عددی
برای ساخت دادههای بازهای (مانند نقاط زمان یا محورهای مختصات) از این دو تابع استفاده میکنیم.
تابع np.arange()
تولید دنبالهای از اعداد در یک بازه معین با گام مشخص. مشابه تابع توکار range پایتون است با دو برتری: خروجی آن آرایه است و از گامهای اعشاری نیز پشتیبانی میکند.
- np.arange(start, stop, step) (عدد پایانی
stopدر خروجی لحاظ نمیشود).
# تولید اعداد صحیح از ۱ تا ۱۰ با گام ۲
seq_int = np.arange(1, 10, 2)
print(seq_int)
# خروجی: [1 3 5 7 9]

# تولید اعداد اعشاری از ۰ تا ۱ با گام ۰.۲
seq_float = np.arange(0, 1, 0.2)
print(seq_float)
# خروجی: [0.  0.2 0.4 0.6 0.8]
تابع np.linspace()
تولید تعداد مشخصی عدد با فاصلههای کاملاً مساوی و یکنواخت درون یک بازه.
-
np.linspace(start, stop, num)(برخلافarange، در اینجا خود عدد پایانیstopپیشفرض شامل بازه است).
# تولید ۵ نقطه با فاصله کاملاً برابر بین ۰ تا ۱۰۰
points = np.linspace(0, 100, 5)

print(points)
# خروجی: [  0.  25.  50.  75. 100.]
ج) تولید دادههای تصادفی
ماژول تصادفی در نامپای (np.random) شامل توابع متعددی است که هرکدام برای یک هدف خاص (تولید عدد صحیح، توزیع یکنواخت، توزیع نرمال یا تثبیت نتایج) استفاده میشوند.
تثبیت تصادفی با np.random.seed()
اعداد تصادفی در کامپیوتر در واقع «شبهتصادفی» (Pseudo-random) هستند. با تعیین یک عدد به عنوان seed (هسته اولیه)، ترتیبی میدهیم که الگوریتم در هر بار اجرا، دقیقاً همان اعداد تصادفی قبلی را بازتولید کند. این کار برای تکرارپذیری نتایج آزمایشها و پروژهها ضروری است.
# تعیین عدد هسته
np.random.seed(42)

# اجرای اول
print("تولید تصادفی:", np.random.rand(3))

# اگر دوباره seed را 42 بگذاریم، خروجی دقیقاً همان قبلی خواهد بود
np.random.seed(42)
print("تکرار مجدد:", np.random.rand(3))
عدد تصادفی با توزیع یکنواخت بین ۰ و ۱
اعداد اعشاری تصادفی تولید میکند که همگی در بازه نیمهباز [0, 1) قرار دارند و احتمال انتخاب تمام اعداد در این بازه یکسان است (توزیع یکنواخت یا Uniform). ابعاد خروجی را مستقیماً به عنوان آرگومانهای مجزا میگیرد (نه در قالب تاپل).
# تولید ماتریس ۲ سطر و ۳ ستون از اعداد اعشاری بین ۰ و ۱
rand_uniform = np.random.rand(2, 3)

print("ماتریس تصادفی یکنواخت:")
print(rand_uniform)
عدد تصادفی با توزیع نرمال استاندارد
اعدادی با «توزیع گاوسی/نرمال استاندارد» تولید میکند. در این توزیع، میانگین اعداد برابر با ۰ و انحراف معیار آنها برابر با ۱ است. بنابراین اکثر اعداد تولید شده در بازه بین -3 تا +3 قرار میگیرند (و حوالی صفر تراکم بیشتری دارند). در مقداردهی اولیه وزنهای شبکههای عصبی کاربرد فراوان دارد.
# تولید ماتریس ۲ در ۲ با توزیع نرمال استاندارد (میانگین ۰ و واریانس ۱)
rand_normal = np.random.randn(2, 2)

print("ماتریس تصادفی توزیع نرمال:")
print(rand_normal)
عدد صحیح تصادفی
برای تولید اعداد صحیح تصادفی در یک بازه دلخواه [low, high) استفاده میشود. عدد شروع در بازه هست، اما عدد پایان لحاظ نمیشود. اندازه و شکل آرایه با پارامتر size مشخص میگردد.
الگو: np.random.randint(low, high, size)
# تولید بردار ۵ عضوی از اعداد صحیح تصادفی بین ۱۰ تا ۵۰ (خود ۵۰ تولید نمیشود)
rand_ints = np.random.randint(10, 50, size=5)
print("اعداد صحیح تصادفی:")
print(rand_ints)
۲. قاعده انتشار (Broadcasting)
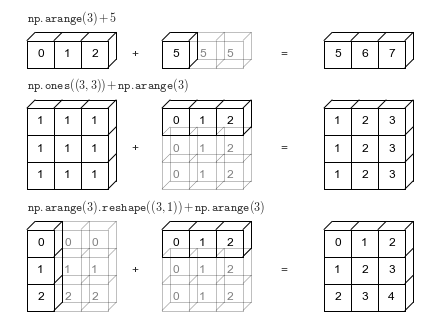
وقتی میخواهید دو آرایه با ابعاد نامساوی را با هم جمع یا ضرب کنید (مثلاً افزودن عدد ۲ به تمام نمرات یک ماتریس)، نامپای بهطور خودکار آرایه کوچکتر را کش میدهد تا هماندازه آرایه بزرگتر شود؛ بدون اینکه حافظه اضافی مصرف کند.
قانون تطبیق ابعاد:
نامپای ابعاد را از سمت راست به چپ مقایسه میکند. دو آرایه زمانی میتوانند در یک عملیات ریاضی (جمع، ضرب، تفریق و…) شرکت کنند که برای هر بعد، یکی از این دو شرط برقرار باشد:
- یا اندازهشان کاملاً برابر باشد.
- یا اندازه یکی از آنها ۱ باشد (تا نامپای بتواند آن را کش بیاورد و به دیگری برساند).
قاعده سرانگشتی: اگر دو عدد در یک ستون نابرابر بودند و هیچکدام هم ۱ نبودند، نامپای خطای ValueError میدهد!
جمع یک عدد تک (اسکالر) با یک ماتریس
- ابعاد: ماتریس با ابعاد
(2, 3)با یک عدد تک (بعد1) جمع میشود. عدد تک در هر دو جهت سطر و ستون کش میآید.
matrix = np.array([[10, 20, 30],
[40, 50, 60]])
# عدد ۵ به تمام درایهها اضافه میشود
result = matrix + 5
print("جمع ماتریس با یک عدد:")
print(result)
جمع یک بردار سطری با یک ماتریس (انتشار در راستای سطرها)
- ماتریس A: دارای ابعاد
(2, 3)(۲ سطر و ۳ ستون) - بردار B: دارای ابعاد
(3,)(۳ ستون) - بررسی قاعده: بعد ستونها در هر دو ۳ است (برابرند). سطر بردار B عملاً ۱ در نظر گرفته شده و روی تمام ۲ سطر ماتریس تکرار (کشیده) میشود.
A = np.array([[1, 2, 3],
[4, 5, 6]])
B = np.array([10, 20, 30])
# بردار B به تکتک سطرهای A اضافه میشود
result = A + B
print("نتیجه انتشار بردار سطری روی ماتریس:")
print(result)
# خروجی:
# [[11 22 33]
# [14 25 36]]
جمع بردار ستونی با بردار سطری (تولید ماتریس)
- بردار A (ستونی): ابعاد
(3, 1) - بردار B (سطری): ابعاد
(1, 3) - بررسی قاعده: ستون A کش میآید تا ۳ ستون شود، سطر B هم کش میآید تا ۳ سطر شود. نتیجه یک ماتریس
(3, 3)خواهد بود!
col_vector = np.array([[1],
                       [2],
                       [3]])  # شکل: (3, 1)

row_vector = np.array([10, 20, 30]) # شکل: (1, 3)

result = col_vector + row_vector

print("نتیجه جمع بردار ستونی و سطری:")
print(result)
# خروجی یک ماتریس 3x3:
# [[11 21 31]
#  [12 22 32]
#  [13 23 33]]
خطا در عدم سازگاری ابعاد
- اگر ماتریس
(2, 3)را بخواهیم با برداری با ابعاد(2,)به شکل سطری جمع کنیم: بعد آخر اولی ۳ و بعد آخر دومی ۲ است. چون نه برابرند و نه یکی از آنها ۱ است، عملیات متوقف میشود.
matrix = np.array([[1, 2, 3],
[4, 5, 6]]) # ابعاد: (2, 3)
vector = np.array([10, 20]) # ابعاد: (2,)
# خط زیر اجرا نمیشود و خطا خواهد داد:
# invalid_sum = matrix + vector
# ValueError: operands could not be broadcast together with shapes (2,3) (2,)
3. عملیات حسابی و محاسبات برداری
بردارسازی (Vectorization) به این معناست که تمام اپراتورهای ریاضی مستقیماً و همزمان روی تمام عناصر آرایه اعمال میشوند، بدون اینکه نیاز به نوشتن حلقه باشد. نامپای حلقه پایتون رو حذف میکنه و محاسبه رو در سطح پردازنده (CPU) با استفاده از زبان C و قابلیت SIMD (یعنی یک دستور روی چندین داده – Single Instruction, Multiple Data) همزمان انجام میدهد.
- شرط اصلی Vectorization پایه: دو تا آرایه از قبل هماندازه هستند (مثلاً دو تا آرایه ۱۰۰۰ عضوی).
| نوع عملیات | تابع معادل در نامپای | کاربرد / توضیحات |
|---|---|---|
| جمع | np.add(a, b) | جمع عنصر به عنصر دو آرایه |
| تفریق | np.subtract(a, b) | تفریق عنصر به عنصر |
| ضرب | np.multiply(a, b) | ضرب عنصر به عنصر (با ضرب ماتریسی متفاوت است) |
| تقسیم اعشاری | np.divide(a, b) | تقسیم تمام عناصر (خروجی اعشاری) |
| تقسیم صحیح | np.floor_divide(a, b) | خارجقسمت تقسیم صحیح |
| باقیمانده | np.mod(a, b) | باقیمانده تقسیم عناصر |
| توان | np.power(a, b) | به توان رساندن عناصر |
| قدر مطلق | np.abs(a) | محاسبه قدر مطلق اعداد منفی یا مختلط |
a = np.array([10, 20, 30, 40])
b = np.array([1, 2, 3, 4])
# محاسبات حسابی با اپراتورها (Element-wise)
print("جمع دو آرایه:", a + b)
print("تفریق دو آرایه:", a - b)
print("ضرب عنصر به عنصر:", a * b)
print("تقسیم دو آرایه:", a / b)
print("توان رساندن:", b ** 2)
# محاسبات با توابع معادل (ufuncs)
add_result = np.add(a, b)
mod_result = np.mod(a, 3)
print("نتیجه np.add:", add_result)
print("باقیمانده تقسیم بر ۳:", mod_result)
۴. توابع ریاضی، لگاریتمی و آماری پیشرفته
نامپای مجموعهای از توابع بهینهشده برای جبر خطی و آمار ارائه میدهد:
| دستهبندی | نام تابع / متد | کاربرد / توضیحات |
|---|---|---|
| آماری | np.sum() / .sum() | مجموع کل یا مجموع در راستای یک محور |
np.mean() / .mean() | میانگین حسابی | |
np.median() | میانه (عنصر وسط دادههای مرتبشده) | |
np.std() / .std() | انحراف معیار (Standard Deviation) | |
np.var() / .var() | واریانس | |
np.min() / np.max() | کمترین و بیشترین مقدار | |
np.argmin() / np.argmax() | اندیس کمترین و بیشترین مقدار | |
| لگاریتمی و نمایی | np.log() | لگاریتم طبیعی (پایه e) |
np.log10() | لگاریتم بر پایه ۱۰ | |
np.log2() | لگاریتم بر پایه ۲ | |
np.exp() | تابع نمایی (e^x) | |
np.sqrt() | جذر گرفتن از عناصر | |
| مثلثاتی و گردکردن | np.sin(), np.cos(), np.tan() | توابع مثلثاتی (ورودی به رادیان) |
np.round(), np.floor(), np.ceil() | گرد کردن به نزدیکترین، کف و سقف |
الف) توابع لگاریتمی و نمایی
این توابع روی تکتک عناصر آرایه اعمال میشوند و برای نرمالسازی دادهها یا توابع فعالسازی (Activation Functions) در یادگیری عمیق ضروری هستند.
x = np.array([1.0, 10.0, 100.0])

# محاسبه لگاریتم طبیعی، لگاریتم بر پایه ۱۰ و تابع نمایی
log_natural = np.log(x)
log_base10 = np.log10(x)
exp_val = np.exp(np.array([1, 2]))

print("لگاریتم طبیعی (ln):", log_natural)
print("لگاریتم پایه ۱۰:", log_base10)
print("تابع نمایی (e^x):", exp_val)
ب) توابع آماری و مفهوم Axis
توابع آماری میتوانند روی کل آرایه یا در راستای یک محور خاص (سطری یا ستونی) محاسبه شوند.
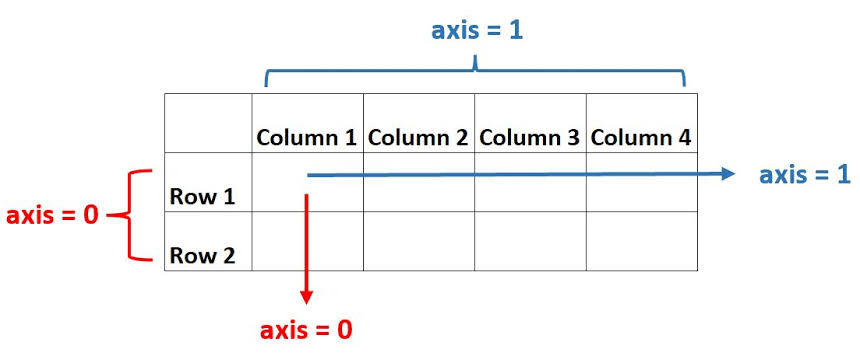
axis=0: عملیات در راستای عمودی (بین سطرها / محاسبات روی هر ستون)axis=1: عملیات در راستای افقی (بین ستونها / محاسبات روی هر سطر)
متد x.sum() (مجموع عناصر) تمام عناصر آرایه را جمع میکند. همچنین اگر پارامتر axis را مشخص کنید، میتواند جمع سطرها یا جمع ستونها را به صورت جداگانه حساب کند.
متد x.mean() (میانگین عناصر) میانگین حسابی (Arithmetic Mean) تمام دادههای موجود در آرایه را محاسبه میکند.
data = np.random.randint(1, 100, size=(3, 4))
print("دادهها:\n", data)
print("انحراف معیار کل:", np.std(data))
print("واریانس کل:", np.var(data))
print("میانه (Median):", np.median(data))
# محاسبه میانگین هر ستون (axis=0)
print("میانگین ستونها:", np.mean(data, axis=0))
# پیدا کردن اندیس بزرگترین عنصر (Argmax)
print("اندیس بزرگترین عنصر در کل آرایه:", np.argmax(data))
data = np.array([[10, 20, 30],
[40, 50, 60]])
print("مجموع کل عناصر:", np.sum(data))
print("میانگین کل عناصر:", np.mean(data))
# محاسبه میانگین در راستای ستونها (عمودی)
mean_per_column = np.mean(data, axis=0)
print("میانگین هر ستون (axis=0):", mean_per_column)
# محاسبه مجموع در راستای سطرها (افقی)
sum_per_row = np.sum(data, axis=1)
print("مجموع هر سطر (axis=1):", sum_per_row)
4. جبر خطی و عملیات ماتریسی
برای کارهای پردازش سیگنال، تصویر و یادگیری ماشین، عملیات جبر خطی (Linear Algebra) بخش جداییناپذیر برنامهنویسی است.
| نوع عملیات | ویژگی / تابع | توضیحات |
|---|---|---|
| ترانهاده (Transpose) | arr.T یا np.transpose(arr) | تعویض جای سطرها و ستونها |
| ضرب ماتریسی | A @ B یا np.dot(A, B) | ضرب جبر خطی ماتریسها |
| معکوس ماتریس | np.linalg.inv(A) | محاسبه ماتریس معکوس (A^{-1}) |
| دترمینان | np.linalg.det(A) | محاسبه دترمینان ماتریس مربع |
| مقادیر و بردارهای ویژه | np.linalg.eig(A) | محاسبه Eigenvalues و Eigenvectors |
| نرم بردار/ماتریس | np.linalg.norm(A) | محاسبه اندازه طول بردار یا نرم ماتریس |
الف) ترانهاده ماتریس (Transpose)
جابهجا کردن سطرها و ستونهای یک ماتریس با استفاده از ویژگی .T یا تابع np.transpose().
arr = np.arange(1, 7).reshape(2, 3)
print("ماتریس اولیه (2x3):\n", arr)

# ترانهاده (تبدیل به 3x2)
print("ترانهاده (3x2):\n", arr.T)
ب) ضرب ماتریسی (Dot Product) vs ضرب عنصر به عنصر
- ضرب عنصر به عنصر: با اپراتور
* - ضرب جبر خطی (ماتریسی): با اپراتور
@یا تابعnp.dot()
A = np.array([[1, 2], [3, 4]])
B = np.array([[5, 6], [7, 8]])
# ضرب جبر خطی ماتریسها
dot_product = A @ B
print("ضرب ماتریسی (Dot Product):\n", dot_product)
# خروجی:
# [[19 22]
# [43 50]]
# تعریف دو ماتریس مربع ۲x۲
A = np.array([[2, 1],
              [5, 3]])

B = np.array([[1, 4],
              [2, 0]])


# ۳. محاسبه دترمینان ماتریس A
determinant = np.linalg.det(A)
print("\nدترمینان ماتریس A:", determinant)

# ۴. محاسبه معکوس ماتریس A
inverse_A = np.linalg.inv(A)
print("\nمعکوس ماتریس A:\n", inverse_A)
Vectorization (بردارسازی): یعنی «چگونه کد اجرا میشود» (حذف حلقههای کُند پایتون و بردن محاسبات به دل پردازنده با زبان C).
Broadcasting (پخش/انتشار): یعنی «چگونه ابعاد نامتناسب با هم جور میشوند» (کش آوردن ابعاد کوچکتر بدون کپی در حافظه تا بشه رویشان محاسبه کرد).