آموزش Numpy: بخش سوم

آموزش Numpy: بخش سوم
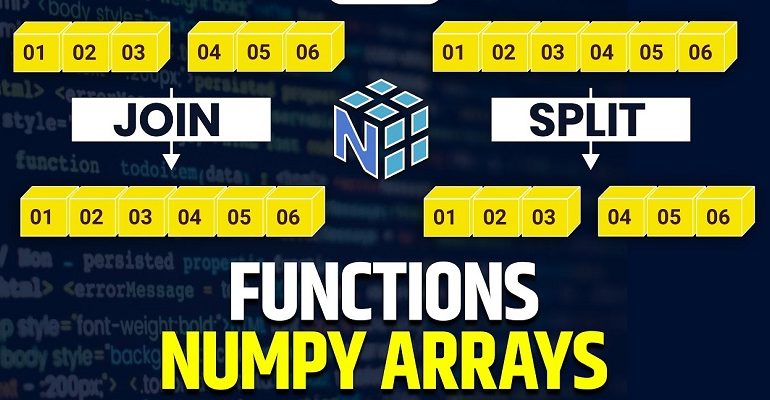
تا اینجا با ساخت آرایه، بردارسازی و جبر خطی آشنا شدیم. اما در پروژههای واقعی هوش مصنوعی، علوم داده و پردازش سیگنال، دادهها همیشه آماده و تمیز نیستند. در این فصل یاد میگیرید چگونه آرایهها را به هم متصل یا خرد کنید، دادهها را بدون خطای ناخواسته در حافظه کپی کنید، با دادههای نامعتبر یا گمشده (NaN) کار کنید و در نهایت نتایج را روی دیسک ذخیره نمایید.
فهرست مطالب
۱. اتصال و ادغام آرایهها (Joining Arrays)
در پردازش دادهها بارها نیاز داریم که دستههای مختلف داده را در کنار هم یا روی هم قرار دهیم.
| تابع | معادل محوری در آرایه ۲ بعدی | چه وقت از آن استفاده کنیم؟ |
|---|---|---|
np.vstack | concatenate(..., axis=0) | وقتی میخواهی رکوردها یا نمونههای جدید (سردستی و سریع) اضافه کنی |
np.hstack | concatenate(..., axis=1) | وقتی میخواهی ستونها یا ویژگیهای جدید (Features) اضافه کنی |
np.concatenate | با پارامتر axis تنظیم میشود | حالت استاندارد و برای آرایههای بالاتر از ۲ بعد |
np.stack | ساخت بعد جدید در موقعیت axis | وقتی میخواهی چند عکس یا سیگنال را تبدیل به یک Batch کنی |
۱. اتصال عمودی با (Vertical Stack)
- مفهوم: مثل چیدن کتابها روی همدیگر است. آرایهها از بالا به پایین (در امتداد سطرها) به هم وصل میشوند و تعداد سطرها افزایش مییابد.
- شرط مهم: تعداد ستونها (عرض) هر دو آرایه باید دقیقاً برابر باشد.
import numpy as np
# فرض کن دو تا ماتریس با ۲ سطر و ۳ ستون داریم
A = np.array([[1, 2, 3],
[4, 5, 6]])
B = np.array([[7, 8, 9],
[10, 11, 12]])
# چسباندن عمودی: B زیر A قرار میگیرد
result = np.vstack((A, B))
print("نتیجه vstack (ابعاد 4x3 میشود):\n", result)
# خروجی:
# [[ 1 2 3]
# [ 4 5 6]
# [ 7 8 9]
# [10 11 12]]
۲. اتصال افقی با (Horizontal Stack)
- مفهوم: مثل گذاشتن کتابها در قفسه کنار همدیگر است. آرایهها از چپ به راست (در امتداد ستونها) پهلوی هم قرار میگیرند و تعداد ستونها افزایش مییابد.
- شرط مهم: تعداد سطرهای هر دو آرایه باید کاملاً برابر باشد تا لبههایشان با هم جفت شود.
# دو ماتریس با ۲ سطر، ولی تعداد ستونهای متفاوت
A = np.array([[1, 2],
[3, 4]]) # ابعاد: (2, 2)
B = np.array([[5, 6, 7],
[8, 9, 10]]) # ابعاد: (2, 3)
# چسباندن افقی: B در سمت راست A قرار میگیرد
result = np.hstack((A, B))
print("نتیجه hstack (ابعاد 2x5 میشود):\n", result)
# خروجی:
# [[ 1 2 5 6 7]
# [ 3 4 8 9 10]]
۳. تابع جامع و همهکاره:
تابع np.concatenate() در واقع پدرِ تمام توابع بالاست! این تابع به جای اینکه نامهای جداگانهای مثل vstack یا hstack داشته باشد، یک پارامتر به نام axis میگیرد و میگوید: «به من بگو در راستای کدام محور بچسبانم؟»
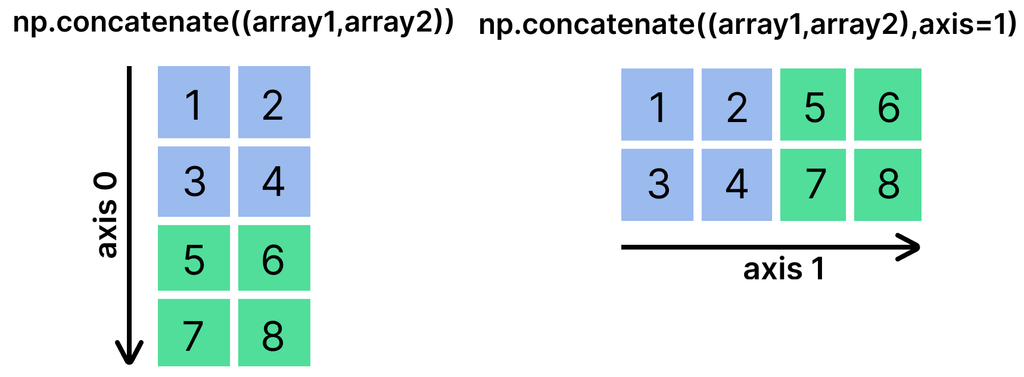
axis=0: یعنی در راستای عمودی (سطری) بچسبان دقیقاً معادلvstackaxis=1: یعنی در راستای افقی (ستونی) بچسبان دقیقاً معادلhstack
A = np.array([[1, 2],
              [3, 4]])

B = np.array([[5, 6],
              [7, 8]])

# ۱. اتصال عمودی (سوار کردن روی هم با axis=0)
concat_axis0 = np.concatenate((A, B), axis=0)
print("اتصال با axis=0:\n", concat_axis0)
# خروجی (4x2):
# [[1 2]
#  [3 4]
#  [5 6]
#  [7 8]]

# ۲. اتصال افقی (گذاشتن کنار هم با axis=1)
concat_axis1 = np.concatenate((A, B), axis=1)
print("\nاتصال با axis=1:\n", concat_axis1)
# خروجی (2x4):
# [[1 2 5 6]
#  [3 4 7 8]]
۴. ساخت بعد جدید (تفاوت بسیار مهم!)
خیلی از برنامهنویسها np.stack را با np.concatenate اشتباه میگیرند!
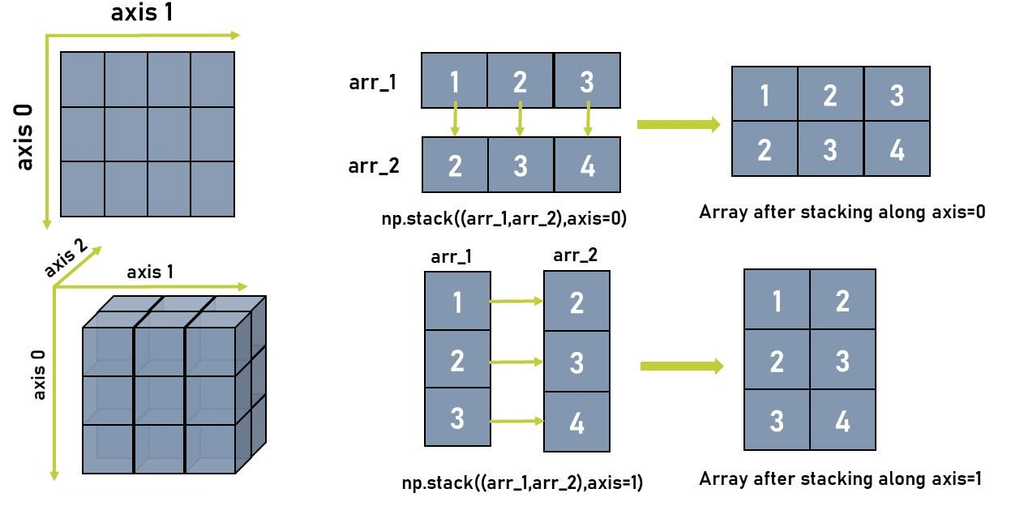
- تفاوت کلیدی: تمام توابع قبلی آرایهها را در دل همان ابعاد قبلی بزرگ میکردند (۲ بعدی + ۲ بعدی = ۲ بعدی). اما
np.stackیک بُعد کاملاً جدید به آرایه اضافه میکند! - تشبیه: فرض کن دو برگه کاغذ (آرایه ۲ بعدی) داری. اگر آنها را به هم چسب بزنی یک کاغذ بزرگتر میشود (
concatenate)؛ اما اگر آنها را روی هم بگذاری تا یک دفترچه ۳ بعدی درست شود، این کارstackاست.
# دو بردار یکبعدی (هر کدام ۳ عضو دارند)
a = np.array([1, 2, 3]) # شکل: (3,)
b = np.array([4, 5, 6]) # شکل: (3,)
# حالت اول: با concatenate بعد جدید ساخته نمیشود
c = np.concatenate((a, b))
print("شکل با concatenate:", c.shape) # خروجی: (6,) - همان ۱ بعدی باقی ماند
# حالت دوم: با stack یک بعد جدید متولد میشود!
s0 = np.stack((a, b), axis=0)
print("شکل با stack (axis=0):", s0.shape) # خروجی: (2, 3) - تبدیل به ۲ بعدی شد!
print("محتوا:\n", s0)
s1 = np.stack((a, b), axis=1)
print("شکل با stack (axis=1):", s1.shape) # خروجی: (3, 2)
print("محتوا:\n", s1)
۲. دونیم کردن آرایهها (Splitting Arrays)
همانطور که برای سرهمکردن آرایهها از ادغام (Stack/Concatenate) استفاده میکنیم، برعکسش هم پیش میآید؛ یعنی میخواهیم یک آرایه یا ماتریس بزرگ را به چند تکه کوچکتر تقسیم کنیم (دقیقاً مثل وقتی که دادهها را به دو بخش Train و Test تقسیم میکنیم).
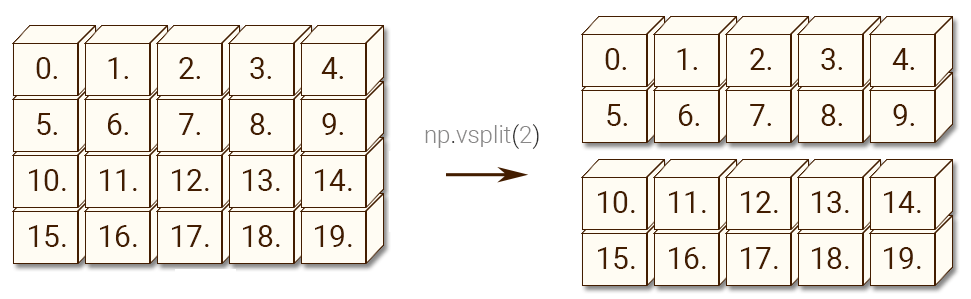
نامپای برای این کار سه تابع کاربردی دارد:
np.hsplit()(خرد کردن افقی): ماتریس را در راستای ستونها برش میزند (برش عمودی تا ستونهای چپ و راست جدا شوند).np.vsplit()(خرد کردن عمودی): ماتریس را در راستای سطرها برش میزند (برش افقی تا سطرهای بالا و پایین جدا شوند).np.split()یاnp.array_split(): تابع عمومی که با پارامترaxisکار میکند. تابعnp.split()اگر تعداد عناصر بر تعداد تکهها بخشپذیر نباشد خطایValueErrorمیدهد، اماnp.array_split()باهوش است و تکهها را تا جای ممکن متوازن میسازد بدون اینکه برنامه کرش کند!
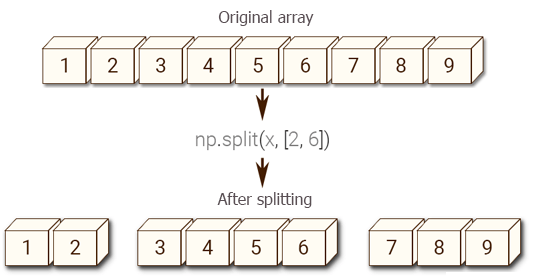
# یک ماتریس ۴ در ۴ بسازیم
matrix = np.array([
[10, 20, 30, 40],
[50, 60, 70, 80],
[11, 22, 33, 44],
[55, 66, 77, 88]
])
# ۱. برش عمودی (vsplit): تقسیم سطرها به دو بخش بالا و پایین
top, bottom = np.vsplit(matrix, 2)
print("بخش بالایی (vsplit):\n", top)
print("بخش پایینی (vsplit):\n", bottom)
# ۲. برش افقی (hsplit): تقسیم ستونها به دو بخش چپ و راست
left, right = np.hsplit(matrix, 2)
print("\nبخش چپ (hsplit):\n", left)
print("بخش راست (hsplit):\n", right)
# ۳. تابع array_split (بسیار کارآمد وقتی ابعاد بخشپذیر نباشند)
# مثلا تقسیم آرایه ۵ عضوی به ۳ بخش (که با split عادی ارور میدهد):
arr = np.array([1, 2, 3, 4, 5])
chunks = np.array_split(arr, 3)
print("\nتقسیم نامتقارن:", chunks)
۳. تله حافظه در نامپای: نما (View) در برابر کپی عمیق (Copy)
این بخش یکی از مهمترین و خطرسازترین مفاهیم نامپای است و منبع ۹۰٪ باگهای پنهان در پروژههای پردازش داده و یادگیری ماشین به حساب میآید!
چرا نامپای این کار را میکند؟
اگر یک آرایه ۱۰ گیگابایتی از سیگنالها یا تصاویر پزشکی در رم داشته باشی و بخواهی فقط سطر اول آن را برش بزنی، نامپای اگر بخواهد یک کپی جدید بسازد، هم رم پر میشود و هم سرعت به شدت افت میکند. بنابراین، نامپای فقط یک «پنجره جدید» (View) رو به همان خانه حافظه قبلی باز میکند! برشزدن (Slicing) یک نما (View) میسازد نه یک آرایه مستقل!
- کپی (Copy): دادهها در یک فضای حافظه کاملاً مستقل و مجزا کپی میشوند. تغییر در یکی، هیچ ربطی به دیگری ندارد.یکی از بزرگترین دلایل ایجاد باگهای پنهان در پایتون، درک نکردن تفاوت View و Copy در نامپای است.
- نما (View): داده جدیدی تولید نمیشود؛ فقط زاویه دید عوض شده است. اگر داده را در نما دستکاری کنی، آرایه اصلی هم تغییر میکند!
# آرایه اصلی
original = np.array([10, 20, 30, 40])
# ==========================================
# سناریوی اول: خطر نما (View) با استفاده از Slicing
# ==========================================
view_arr = original[0:2] # فقط یک نماست!
view_arr[0] = 999 # تغییر روی نما
print("تغییر روی نما انجام شد.")
print("آرایه فرعی:", view_arr)
print("آرایه اصلی دستکاری شد!:", original) # مقدار اول 999 شده!
# ==========================================
# سناریوی دوم: راه حل امن؛ ساخت کپی مستقل با .copy()
# ==========================================
original = np.array([10, 20, 30, 40])
safe_copy = original[0:2].copy() # حافظه کاملاً جداگانه
safe_copy[0] = 777 # تغییر روی کپی
print("\nتغییر روی کپی امن انجام شد.")
print("آرایه کپی شده:", safe_copy)
print("آرایه اصلی دستنخورده باقی ماند:", original) # همان [10, 20, 30, 40]
چطور پشت صحنه بفهمیم یک آرایه View است یا Copy؟ (ویژگی .base)
هر آرایه در نامپای ویژگی به اسم .base دارد:
- اگر خروجی
Noneباشد ← یعنی این آرایه خودش مالک داده است (یا مستقل کپی شده). - اگر خروجی یک آرایه دیگر را نشان داد ← یعنی این یک View از آن آرایه است!
# بررسی مالکیت حافظه با ویژگی base
print(view_arr.base is original)   # True: یعنی این صرفاً یک نما از original است!
print(safe_copy.base is None)      # True: یعنی حافظه مال خودش است و مستقل است!
۴. جایگزینی شرطی و مدیریت مقادیر NaN
در دنیای واقعی دادهها همیشه تمیز نیستند؛ پر از دادههای گمشده (NaN) یا مقادیری هستند که باید بر اساس یک شرط خاص جایگزین شوند.
الف: جایگزینی و فیلتر شرطی با np.where()
تابع np.where() مثل دستور if-else در پایتون عمل میکند، اما با این تفاوت بزرگ که بهصورت برداری (Vectorized) روی تکتک عناصر آرایه با سرعت فوقالعاده بالا اجرا میشود.نحوه کار این تابع به دو شکل است:
۱. شکل سه پارامتره (جایگزینی شرطی مثل if-else):
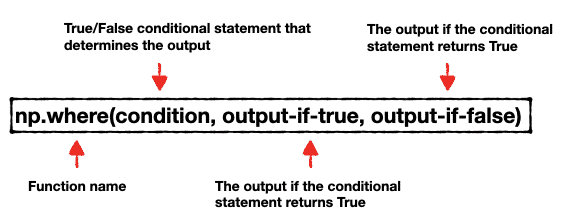
np.where(condition, x, y)
- اگر شرط درست (
True) باشد، مقدارxجایگزین میشود. - اگر شرط غلط (
False) باشد، مقدارyجایگزین میشود.
# فرض کن نمرات یک کلاس را داری
scores = np.array([12, 18, 8, 15, 9, 20])
# میخواهیم نمرات زیر ۱۰ را "مردود" و ۱۰ به بالا را "قبول" کنیم
status = np.where(scores >= 10, "قبول", "مردود")
print("نمرات اصلی:", scores)
print("وضعیت دانشآموزان:", status)
# خروجی: ['قبول' 'قبول' 'مردود' 'قبول' 'مردود' 'قبول']
# یک مثال کاربردی دیگر: کپ کردن (Limit) مقادیر پرتی که از حد مجاز بالاترند
# اگر عددی از ۱۵ بزرگتر بود، بکنش ۱۵؛ وگرنه خود عدد بمونه
clipped_scores = np.where(scores > 15, 15, scores)
print("نمرات تعدیلشده:", clipped_scores)
۲. شکل تک پارامتره (یافتن اندیسها):
اگر فقط شرط را به np.where(condition) بدهی، به جای تغییر مقادیر، موقعیت (اندیس) خانه هایی که شرط در آنها برقرار است را برمیگرداند:
arr = np.array([10, 50, 20, 80, 30])

# پیدا کردن اندیس عناصری که از ۳۰ بزرگتر هستند
indices = np.where(arr > 30)

print("اندیس مقادیر بزرگتر از ۳۰:", indices[0]) # خروجی: [1, 3]
print("خود آن مقادیر:", arr[indices])          # خروجی: [50, 80]
بخش دوم: مدیریت مقادیر مفقودی (NaN) و بینهایت (Inf)
در محاسبات واقعی، هوش مصنوعی و تحلیل داده، خیلی پیش میآید که حسگرها قطع شوند یا دادهای ثبت نشود. نامپای برای دادههای گمشده از np.nan (مخفف Not a Number) و برای تقسیم بر صفر از np.inf استفاده میکند.
تله بزرگ نامپای: هر عملیات ریاضی روی
NaNخروجی راNaNمیکند! مثلاً10 + np.nanمیشودNaN. همچنین جمع یک آرایه حاویNaNباnp.sum()کلاً خراب میشود وNaNمیدهد!
۱. تشخیص مقادیر NaN و Inf:
برای بررسی وجود این دادهها نباید از == استفاده کنی (چون np.nan == np.nan برابر با False است!). باید از توابع مخصوص نامپای استفاده کنی:
data = np.array([10.0, np.nan, 25.0, np.nan, 50.0])
# بررسی وجود NaN (خروجی یک آرایه بولین است)
print("آیا NaN هست؟:", np.isnan(data))
# خروجی: [False True False True False]
# شمارش تعداد دادههای گمشده
print("تعداد NaNها:", np.isnan(data).sum()) # خروجی: 2
۲. محاسبات امن با توابع nan-safe:
نامپای برای اکثر توابع آماری مثل sum, mean, std, min, max یک نسخه nan هم دارد که مقادیر مفقودی را نادیده میگیرد و محاسبات را درست انجام میدهد:
data = np.array([10.0, np.nan, 20.0, 30.0])
# تابع عادی (خراب میشود!)
print("میانگین با تابع عادی:", np.mean(data)) # خروجی: nan
# تابع امن (NaN را نادیده میگیرد و میانگین ۱۰، ۲۰ و ۳۰ را حساب میکند)
print("میانگین امن (nanmean):", np.nanmean(data)) # خروجی: 20.0
print("مجموع امن (nansum):", np.nansum(data)) # خروجی: 60.0
۳. پاکسازی و جایگزینی مقادیر NaN (ترکیب با np.where یا np.nan_to_num):
روش اول: جایگزینی NaN با میانگین دادهها (تکنیک رایج در پیشپردازش داده):
data = np.array([10.0, np.nan, 30.0, np.nan, 50.0])
# محاسبه میانگین دادههای معتبر
mean_val = np.nanmean(data)
# جایگزینی NaNها با میانگین محاسبهشده
cleaned_data = np.where(np.isnan(data), mean_val, data)
print("دادههای پاکسازیشده با میانگین:", cleaned_data)
# خروجی: [10. 30. 30. 30. 50.]
روش دوم: استفاده از تابع آماده np.nan_to_num():
import numpy as np
data = np.array([10.0, np.nan, np.inf])
# بهطور خودکار NaN را با 0 و Inf را با یک عدد بسیار بزرگ جایگزین میکند
clean_quick = np.nan_to_num(data, nan=0.0, posinf=9999.0)
print("جایگزینی سریع:", clean_quick)
# خروجی: [ 10. 0. 9999.]
جدول مرجع توابع مدیریت NaN :
| تابع | کاربرد / عملکرد |
|---|---|
np.isnan(arr) | تشخیص خانههایی که مقدار NaN دارند (خروجی True/False) |
np.isinf(arr) | تشخیص خانههایی که مقدار بینهایت (Inf) دارند |
np.nanmean(arr) | محاسبه میانگین با صرفنظر کردن از مقادیر NaN |
np.nansum(arr) | محاسبه مجموع عناصر با نادیده گرفتن NaN |
np.nan_to_num(arr, nan=val) | جایگزینی مستقیم تمام مقادیر NaN با یک عدد دلخواه (مثلاً صفر) |
۵. ذخیرهسازی و بارگذاری آرایهها (I/O در نامپای)
این مبحث دقیقاً نقطه وصل پروژههای محاسباتی به دنیای واقعی است. وقتی یک مدل هوش مصنوعی یا یک پیشپردازش سنگین دادهها را اجرا میکنی، اصلاً منطقی نیست هر بار از اول کل محاسبات را تکرار کنی؛ باید بتوانی آرایهها را خیلی سریع و سبک روی هارد ذخیره کنی و هر وقت خواستی در کسری از ثانیه لودشان کنی. در نامپای دو روش کلی برای ذخیره و بازیابی دادهها داریم:
- فرمتهای باینری اختصاصی نامپای (
.npyو.npz): فوقالعاده سریع، بسیار کمحجم و حافظ تمام ساختار داده (دقیقاً با همان ابعاد و dtype). - فرمتهای متنی عمومی (
.csvو.txt): قابل خواندن توسط انسان و نرمافزارهای دیگر مثل اکسل، اما سنگینتر و کُندتر.
۱. ذخیره و بازیابی یک آرایه باینری (np.save و np.load)
این استاندارد طلایی نامپای است. فرمت .npy داده را به صورت باینری ذخیره میکند؛ یعنی نوع داده (dtype) و ابعاد دقیق آن (shape) بدون هیچگونه اتلاف دقت اعشاری حفظ میشود.
# فرض کن یک آرایه از ویژگیها یا سیگنالها داریم
data = np.random.rand(100, 3)
# ۱. ذخیره آرایه روی دیسک (پسوند npy به طور خودکار اضافه میشود)
np.save("features.npy", data)
# ۲. بارگذاری مجدد از دیسک
loaded_data = np.load("features.npy")
print("شکل داده بارگذاری شده:", loaded_data.shape)
print("آیا داده اولیه با داده لود شده برابر است؟", np.array_equal(data, loaded_data))
مزیت بزرگ
.npy: لود کردن یک فایل باینری ۱۰ گیگابایتی در نامپای معمولاً چند ثانیه بیشتر طول نمیکشد، در حالی که لود کردن همین حجم به صورت متنی یا CSV ممکن است دقیقهها طول بکشد و کل رم را منفجر کند!
۲. ذخیره چند آرایه در یک فایل فشرده (np.savez و np.savez_compressed)
خیلی وقتها ما فقط یک آرایه نداریم؛ مثلاً دادههای آموزش (X_train)، برچسبها (y_train) و دادههای تست (X_test) را داریم و میخواهیم همه داخل یک تکفایل فشرده (مثل ZIP) ذخیره شوند. فرمت خروجی این کار .npz است:
X_train = np.random.rand(80, 10)
y_train = np.random.randint(0, 2, 80)
# ذخیره فشرده چند آرایه با نامگذاری دلخواه
np.savez_compressed("dataset.npz", features=X_train, labels=y_train)
# بارگذاری فایل فشرده
dataset = np.load("dataset.npz")
# دسترسی به آرایهها مانند یک دیکشنری در پایتون
print("نام آرایههای ذخیره شده:", dataset.files)
loaded_X = dataset["features"]
loaded_y = dataset["labels"]
print("ابعاد ویژگیها:", loaded_X.shape)
print("ابعاد برچسبها:", loaded_y.shape)
۳. ذخیره و بارگذاری فایلهای متنی و CSV اکسل (np.savetxt و np.loadtxt)
اگر هدف این باشد که دادهها را به شخصی بدهی که نامپای بلد نیست و میخواهد با اکسل آن را باز کند، باید از فرمتهای متنی مثل CSV استفاده کنی:
data = np.array([
    [10.5, 20.2, 30.1],
    [40.8, 50.4, 60.9]
])

# ذخیره به صورت فایل متنی با جداکننده کاما (CSV)
# پارامتر fmt='%.2f' یعنی اعداد را تا ۲ رقم اعشار ذخیره کن
np.savetxt("output.csv", data, delimiter=",", fmt="%.2f", header="col1,col2,col3", comments="")

# بارگذاری مجدد از فایل متنی
loaded_csv = np.loadtxt("output.csv", delimiter=",", skiprows=1)
print("داده بارگذاری شده از CSV:\n", loaded_csv)
جدول مقایسه:
| روش / فرمت | پسوند فایل | سرعت ذخیره و لود | حفظ ساختار و dtype | کاربرد اصلی |
|---|---|---|---|---|
np.save | .npy | فوقالعاده سریع | ✅ ۱۰۰٪ دقیق | ذخیره یک ماتریس یا تانسور محاسباتی سنگین |
np.savez_compressed | .npz | فوقالعاده سریع + فشردهسازی | ✅ ۱۰۰٪ دقیق | ذخیره پکیج دادهها (مثل X_train و y_train با هم) |
np.savetxt | .csv یا .txt | کُند | ❌ ممکن است دقت اعشار یا ساختار چندبعدی آسیب ببیند | انتقال داده به اکسل، نرمافزارهای آماری یا خواندن انسانی |
در نهایت جدول توابع کاربردی تکمیلی نامپای را در زیر با مثال پایتون آورده شده است.
| دستهبندی | نام تابع / سینتکس | عملکرد و توضیح کوتاه | مثال کدی کاربردی |
|---|---|---|---|
| دستکاری ابعاد | np.newaxis / np.expand_dims() | اضافه کردن یک بعد جدید با اندازه ۱ (حیاتی برای ورودی مدلهای دیپلرنینگ) | arr[:, np.newaxis]تبدیل بردار (N,) به ماتریس ستونی (N, 1) |
| دستکاری ابعاد | np.squeeze() | حذف تمام بعدهای اضافی و تکعضوی (حذف بعدهای ۱) | arr.squeeze() تبدیل شکل (1, 10, 1) به (10,) |
| دستکاری ابعاد | arr.ravel() | تخت کردن ماتریس به بردار ۱ بعدی با ساخت View (برعکس flatten که کپی میسازه) | arr.ravel()فوقالعاده سریعتر و کممصرفتر از flatten |
| مرتبسازی و جستجو | np.argsort() | برگرداندن اندیسهای دادههای مرتبشده (پایه انتخاب برترین احتمالات / Top-K) | idx = np.argsort(probs)[-3:] پیدا کردن اندیس ۳ کلاس برتر |
| مرتبسازی و جستجو | np.sort() | مرتبسازی عناصر آرایه بهصورت صعودی | np.sort(arr, axis=0) سورت کردن هر ستون |
| مقادیر یکتا و شمارش | np.unique() | استخراج مقادیر غیرتکراری، اندیسها و شمارش تعداد تکرار هر کلاس | vals, counts = np.unique(y, return_counts=True) بررسی تعادل کلاسها |
| تحدید و برش مقادیر | np.clip() | محدود کردن بازه دادهها بین حداقل و حداکثر مشخص (بریدن مقادیر پرت) | np.clip(data, 0, 255) نگه داشتن اعداد در بازه تصویر دیجیتال |
| محاسبات تجمعی | np.cumsum() | مجموع تجمعی عناصر آرایه (Cumulative Sum) | np.cumsum([1, 2, 3, 4])خروجی: [1, 3, 6, 10] |
| توابع شرطی پیشرفته | np.select() | پیادهسازی if-elif-else چندگانه بهصورت برداری و بدون حلقه | np.select([x<0, x==0, x>0], [-1, 0, 1]) |
| شبکه مختصاتی | np.meshgrid() | تولید ماتریسهای مختصات ۲ یا ۳ بعدی از روی دو بردار (ضروری برای رسم نمودار سطح و فیلترهای تصویری) | X, Y = np.meshgrid(x_coords, y_coords) |
| بررسی و مقایسه امن | np.allclose() | مقایسه دو آرایه اعشاری با در نظر گرفتن تلورانس خطا (جایگزین امن == برای اعشار) | np.allclose(a, b, atol=1e-5) خروجی True/False |
| تحلیل فرکانسی | np.fft.fft() | تبدیل فوریه سریع (تبدیل سیگنال از حوزه زمان به حوزه فرکانس) | spectrum = np.abs(np.fft.fft(signal)) |
یک کد کوتاه برای تست مهمترینهای جدول:
# ۱. اضافه و کم کردن بعد (newaxis و squeeze)
x = np.array([10, 20, 30]) # shape: (3,)
x_2d = x[:, np.newaxis] # shape: (3, 1) -> ماتریس ستونی
x_back = np.squeeze(x_2d) # shape: (3,) -> برگشت به بردار
# ۲. جادوی argsort (پیدا کردن رتبه دادهها به جای خود داده)
scores = np.array([0.15, 0.85, 0.40])
print("اندیس به ترتیب صعودی:", np.argsort(scores)) # [0, 2, 1]
# ۳. شمارش کلاسها با unique
labels = np.array([0, 1, 1, 0, 2, 1, 0])
classes, counts = np.unique(labels, return_counts=True)
print("کلاسها:", classes) # [0 1 2]
print("فراوانی:", counts) # [3 3 1]
# ۴. مهار کردن دادههای پرت با clip
raw_vals = np.array([-5, 12, 150, 300, 45])
print("مهار شده:", np.clip(raw_vals, 0, 100)) # [ 0 12 100 100 45]