
شبکه عصبی پرسپترون


پرسپترون چیست؟
شبکه عصبی پرسپترون (Perceptron) یکی از قدیمیترین و بنیادیترین مدلهای یادگیری ماشین است که در سال ۱۹۵۷ توسط فرانک روزنبلات (Frank Rosenblatt) معرفی شد. پرسپترون در واقع مدل ریاضی یک نورون زیستی مغز است و به عنوان یک طبقهبندیکننده خطی (Linear Binary Classifier) طراحی شد تا بتواند دادهها را به دو دسته (مثلاً صفر و یک) تقسیم کند.
فهرست مطالب
مدل نورون تکورودی
سادهترین شکل یک پرسپترون (Single-Input Neuron)، نورونی است که فقط یک ورودی اسکالر (p) دریافت میکند:
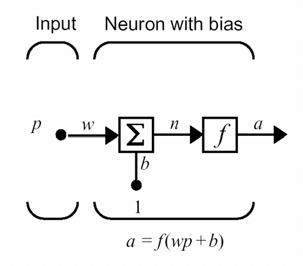
رابطه ریاضی:
$$n = w \cdot p + b$$
$$a = f(n) = f(w \cdot p + b)$$
- p (ورودی): دادهای که وارد نورون میشود.
- w (وزن): قدرت یا اهمیت سیگنال ورودی را تعیین میکند (شیب خط مرز تصمیم).
- b (بایاس): به نورون اجازه میدهد مرز تصمیم را به چپ یا راست منتقل کند (عرض از مبدأ).
- f (تابع فعالساز): خروجی جمع خطی را به محدوده دلخواه نگاشت میکند. در پرسپترون کلاسیک روزنبلات، از تابع پلهای (Hard-Limit / Step) استفاده میشد:
$$f(n) = \begin{cases} 1 & \text{if } n \ge 0 \ 0 & \text{if } n < 0 \end{cases}$$
مدل نورون با چند ورودی
در مسائل دنیای واقعی، دادههای ما چند ویژگی (ابعاد) دارند؛ مثلاً سن، وزن، فشار خون , ویژگی مختلف در این حالت از نرون با چند ورودی (Multi-Input Neuron) استفاده می شود. در این حالت ورودی و وزنها به شکل بردار خواهند بود:
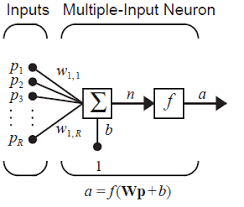
بردار ورودی:
بردار وزنها: ]
$$n = \mathbf{w} \mathbf{p} + b = \sum_{i=1}^{R} w_i p_i + b$$
$$a = f(n) = f(\mathbf{w}\mathbf{p} + b)$$
این معادله دقیقاً معادله یک ابرصفحه (Hyperplane) است که فضای ویژگیها را به دو نیمه جدا میکند.
قانون یادگیری پرسپترون تکلایه
در پرسپترون تکلایه، آموزش بسیار شهودی است. ابتدا وزنها مقادیر تصادفی یا صفر میگیرند، سپس نمونهها یکییکی وارد شبکه میشوند.
فرمول بهروزرسانی وزنها:
خطا (e) برابر است با اختلاف مقدار واقعی (Target) و خروجی پیشبینیشده (a):
$$e = \text{Target} – a$$
اگر پیشبینی درست باشد (e = 0)، هیچ وزنی تغییر نمیکند. اما اگر اشتباه کند، وزنها و بایاس طبق قانون زیر اصلاح میشوند:
$$w_i^{(t+1)} = w_i^{(t)} + \eta \cdot (\text{Target} – a) \cdot p_i$$
$$b^{(t+1)} = b^{(t)} + \eta \cdot (\text{Target} – a)$$
- η (نرخ یادگیری یا Learning Rate): عددی مثبت و کوچک بین 0 تا 1 که سرعت قدمهای یادگیری را تنظیم میکند.
- اگر خروجی باید ۱ میشد ولی شبکه ۰ پیشبینی کرد (e = +1)، وزنها افزایش مییابند تا خروجی بزرگتر شود.
- اگر خروجی باید ۰ میشد ولی شبکه ۱ پیشبینی کرد (e = -1)، وزنها کاهش مییابند.
پیادهسازی گیت منطقی AND در پایتون
برای اینکه ببینید این فرمولها چطور کار میکنند، بیایید عملگر منطقی AND را با NumPy بسازیم. در این بخش ۴ حالت ورودی و خروجی گیت منطقی AND را به عنوان داده ورودی و لیبل ایجاد کردیم .
import matplotlib.pyplot as plt
import numpy as np

# ۱. چهار نقطه گیت AND
X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
y = np.array([0, 0, 0, 1])
در این مرحله الگوریتم یادگیری پرسپترون را بهصورت پایهای پیاده کرده و وزنها و بایاس را با قاعده بهروزرسانی پرسپترون آموزش میدهیم. سپس با قرار دادن وزنهای بهدستآمده در معادله خط ، مرز تصمیمگیری را مستقیماً روی نمودار رسم میکنیم.
import matplotlib.pyplot as plt
import numpy as np
def train_perceptron(X, y, lr=0.1, epochs=10):
# Initialize weights and bias to zeros
weights = np.zeros(X.shape[1])
bias = 0
# Start training loop
for _ in range(epochs):
for p, target in zip(X, y):
# Calculate prediction: 1 if (w*p + b) >= 0, else 0
linear_output = np.dot(weights, p) + bias
prediction = 1 if linear_output >= 0 else 0
# Calculate error
error = target - prediction
# Update weights and bias
weights = weights + lr * error * p
bias = bias + lr * error
return weights, bias
# فراخوانی تابع و آموزش مدل
weights, bias = train_perceptron(X, y, lr=0.1, epochs=10)
print(f"Trained Weights: {weights}, Bias: {bias}")
# رسم نقاط دادهها
plt.scatter(X[y == 0, 0], X[y == 0, 1], color='blue', s=100, label='Class 0 (False)')
plt.scatter(X[y == 1, 0], X[y == 1, 1], color='red', s=100, label='Class 1 (True)')
# محاسبه و رسم خط مرز تصمیم
x1_vals = np.linspace(-0.2, 1.2, 100)
x2_vals = -(weights[0] * x1_vals + bias) / weights[1]
plt.plot(x1_vals, x2_vals, color='green', linestyle='--', label='Decision Boundary')
# تنظیمات نمودار
plt.xlim(-0.2, 1.2)
plt.ylim(-0.2, 1.2)
plt.xlabel('X1')
plt.ylabel('X2')
plt.title('Perceptron Decision Boundary for AND Gate')
plt.legend()
plt.grid(True)
plt.show()
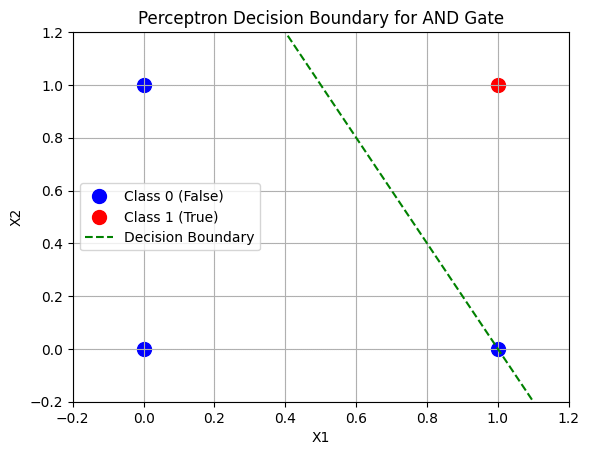
پیادهسازی با کتابخانه Scikit-Learn:
در این بخش همان مسئله را با کلاس آماده Perceptron از کتابخانه Scikit-Learn پیاده کرده و پارامترها را بعد از یادگیری استخراج میکنیم. در نهایت خروجی ویژگیهای coef_ و intercept_ همان وزنها و بایاس شبکه هستند و خط تصمیم حاصل، دادهها را جدا میسازد.
from sklearn.linear_model import Perceptron
# دادهها
X = [[0, 0], [0, 1], [1, 0], [1, 1]]
y = [0, 0, 0, 1]
# تعریف و آموزش مدل
clf = Perceptron(tol=1e-3, random_state=42)
clf.fit(X, y)
# آزمایش پیشبینی
print("پیشبینی برای ورودی [1, 1]:", clf.predict([[1, 1]])) # خروجی: [1]
print("پیشبینی برای ورودی [1, 0]:", clf.predict([[1, 0]])) # خروجی: [0]
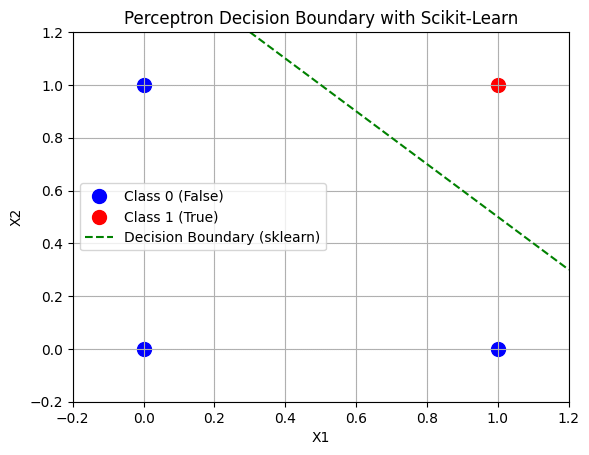
(کد متلب معادل نیز همان دستورات newp و train است که برای تولباکس هوش مصنوعی متلب استفاده میشود).
شبکه پرسپترون در متلب
در این کد ابتدا ورودیهای گیت AND بهصورت ستونی در ماتریسP و پاسخها در بردارT چیده شده و شبکه پرسپترون با تابع train آموزش داده میشود.
سپس با استخراج وزنها (IW) و بایاس (b)، با دو تابع کاربردی plotpv و plotpc بهسادگی نقاط ورودی و خط مرز تصمیم روی نمودار رسم میشوند.
% 1. Define AND gate input patterns (each column is one sample)
P = [0 0 1 1;
     0 1 0 1]; % P1=[0;0], P2=[0;1], P3=[1;0], P4=[1;1]

% 2. Define target outputs for AND gate
T = [0 0 0 1];

% 3. Create a Perceptron network
net = perceptron;

% 4. Train the network
net = train(net, P, T);

% 5. Test the trained network with inputs
Y = net(P);
disp('Predicted outputs:');
disp(Y);

% 6. View learned weights and bias
disp('Trained Weights (w1, w2):');
disp(net.IW{1,1});
disp('Trained Bias:');
disp(net.b{1});

% 7. Plot the decision boundary using MATLAB built-in visualization
plotpv(P, T);       % Plot input vectors
plotpc(net.IW{1,1}, net.b{1}); % Plot classification line (decision boundary)
شبکه پرسپترون چندلایه (MLP) و الگوریتم پسانتشار خطا
در سال ۱۹۶۹، ماروین مینسکی (Marvin Minsky) ثابت کرد پرسپترون تکلایه فقط مسائلی را حل میکند که تفکیکپذیر خطی (Linearly Separable) باشند. به عنوان مثال، پرسپترون ساده توانایی تفکیک گیت منطقی XOR را ندارد!
راه حل چه بود؟ اضافه کردن لایههای پنهان (Hidden Layers) که منجر به ساخت پرسپترون چندلایه (Multilayer Perceptron – MLP) شد.

پرسپترون چندلایه یک شبکه پیشخور (Feedforward) است که از ۳ بخش تشکیل شده:
- لایه ورودی (Input Layer): دریافت ویژگیهای خام.
- لایههای پنهان (Hidden Layers): استخراج ویژگیها و نگاشت غیرخطی با توابع فعالساز پیوسته (مثل Sigmoid, Tanh یا ReLU).
- لایه خروجی (Output Layer): تولید نتیجه نهایی رگرسیون یا دستهبندی.
آموزش MLP چطور انجام میشود؟
چون لایههای میانی هدف مستقیمی ندارند، دیگر نمیتوان از قانون ساده پرسپترون روزنبلات استفاده کرد. اینجا پای دو مفهوم کلیدی باز میشود:
- انتشار رو به جلو (Forward Pass): ورودی از لایهها عبور میکند و پیشبینی نهایی محاسبه میشود.
- محاسبه تابع هزینه (Loss Function): خطای کل شبکه نسبت به پاسخ واقعی محاسبه میگردد (مثلاً میانگین مربعات خطا یا Cross-Entropy).
- پسانتشار خطا (Backpropagation): با استفاده از قاعده زنجیرهای در مشتق (Chain Rule)، مشخص میشود هر وزن در لایههای مختلف چقدر در خطای نهایی مقصر بوده است (گرادیان خطا نسبت به وزن: ).
- بهینهسازی با گرادیان کاهشی (Gradient Descent): وزنها در خلاف جهت شیب (گرادیان) آپدیت میشوند تا به دره کمترین خطا سقوط کنند:
$$W^{(t+1)} = W^{(t)} – \eta \frac{\partial Loss}{\partial W}$$
«گرادیان کاهشی» (Gradient Descent) یک الگوریتم بهینهسازی برای پیدا کردن کمینه یک تابع است. در این الگوریتم کار با یک نقطه تصادفی روی تابع آغاز میشود و روی جهت منفی از گرادیان تابع حرکت میکند تا به کمینه محلی/سراسری برسد.
جدول مقایسه سریع پرسپترون تکلایه با MLP
| ویژگی | پرسپترون تکلایه (SLP) | پرسپترون چندلایه (MLP) |
|---|---|---|
| تعداد لایهها | فقط ورودی و خروجی (فاقد لایه پنهان) | ورودی، خروجی + حداقل یک لایه پنهان |
| نوع مسائل | فقط مسائل خطی (مثل AND و OR) | مسائل پیچیده و غیرخطی (مثل XOR، تصویر، صوت) |
| توابع فعالساز | پلهای / ناپیوسته (Step / Sign) | مشتقپذیر و غیرخطی (ReLU, Sigmoid, Softmax) |
| روش آموزش | قانون یادگیری پرسپترون (Perceptron Rule) | پسانتشار خطا (Backpropagation) + گرادیان کاهشی |




دیدگاه (4)
محمد
بکارم اومد، ممنون
شیرازی
اینستاگرام لب متلب هم متعلق به شماست؟
زهرا سهامی
بله یکی هستن
شبکه عصبي شعاعي مبنا در متلب
[…] ما حداقل به یک لایه پنهان نیاز داریم تا تفکيک غیر خطی داشته باشيم. RBNN کاری که انجام می دهد این است که سیگنال ورودی را به شکل دیگری تبديل مي کند که پس از اعمال آن به شکبه تفکيک خطی را ممکن مي کند. RBNN از نظر ساختاری مشابه پرسپترون (MLP) است. […]