
الگوریتم KNN در کلاس بندی
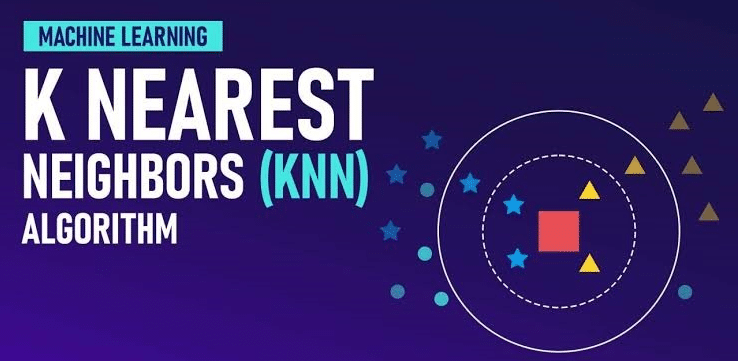

الگوریتم K نزدیک ترین همسایگی (KNN)
یکی از ساده ترین روش های بازشناسی الگو مبتنی بر یادگیری ماشین ، به منظور دسته بندی (Classification) و رگرسیون داده ها، می توان به الگوریتم K نزدیک ترین همسایگی اشاره نمود. سادگی الگوریتم K Nearest Neighbors از نظر پیاده سازی مورد توجه می باشد. اما این سادگی به قیمت تحمیل زمان زیاد محاسبات بلاخص در داده های حجیم، خواهد بود.
فهرست مطالب
- روند کلی الگوریتم
- الگوریتم knn در پایتون
- الگوریتم KNN در متلب
- اهمیت نرمال سازی در KNN
- انتخاب مقدار مناسب K
توجه اصلی این الگوریتم بر روی k تعداد، از نزدیک ترین داده ها به داده ناشناخته می باشد. اگر مقدار k برابر با یک فرض شود، در واقع اشاره به الگوریتم نزدیک ترین همسایگی خواهد داشت. در این حالت تنها یکی از نزدیک ترین داده ها به داده ناشناخته مبنای مشخص کردن کلاس داده خواهد بود.
روند کلی الگوریتم
به طور کی الگوریتم شامل سه فاز زیر می باشد:
- دریافت دادههای اولیه: که شامل بردارهایی در یک فضای چند بعدی هستند که هر کدام شامل برچسبی به نام دسته میباشند.
- فاز یادگیری: الگوریتم، شامل ذخیرهسازی بردارهای ویژگی و برچسب دسته نمونههای اولیه است.
- فاز دسته بندی: که داده های ناشناخته و بدون برچسب با توجه به فاصله اش از k نزدیکترین همسایه برچسب گذاری می شوند.
به منظور درک الگوریتم کافیست مراحل مثال زیر را برای اختصاص داده ناشناخته به دو کلاس شناخته شده به صورت مساله knn تعمیم دهیم:
مرحله اول: مدل سازی مساله و داده های اولیه
در این سناریو، مجموعهای از دادههای آموزشی با برچسبهای مشخص داریم (برای مثال، دو دسته داده شامل کلاس A و کلاس B). هدف ما این است که با ورود یک داده جدید و ناشناخته، بر اساس ویژگیهایش تشخیص دهیم که این داده به کدام کلاس تعلق دارد.

مرحله دوم : تعیین فاصله تمامی داده ها از داده ناشناخته
برای اینکه بفهمیم داده ناشناخته به کدام دادههای قبلی شبیهتر است، فاصله آن را با تکتک دادههای مجموعه آموزش محاسبه میکنیم (فاصله کمتر = شباهت بیشتر).

معیارهای مختلفی برای محاسبه فاصله وجود دارد که پرکاربردترین آنها عبارتند از:
۱. فاصله اقلیدسی (Euclidean Distance):
معیار استاندارد فاصله خط مستقیم بین دو نقطه در فضا:
۲. فاصله منهتن (Manhattan Distance):
مجموع قدرمطلق اختلاف ویژگیها (مشابه حرکت در شبکهای از بلوکهای شهری):
۳. فاصله مینکوفسکی (Minkowski Distance):
حالت تعمیمیافته از فواصل بالا (با پارامتر p):
💡 نکته کلیدی: اگر باشد فرمول به فاصله منهتن و اگر p=2 باشد به فاصله اقلیدسی تبدیل میشود.
مرحله سوم: انتخاب k همسایگی نزدیک
پس از محاسبه فاصله داده جدید با تمام نقاط، فاصلهها را مرتب کرده و k دادهای که کمترین فاصله (بیشترین شباهت) را دارند جدا میکنیم. به عنوان مثال، اگر k=3 در نظر گرفته شود، ۳ نقطهای که نزدیکترین موقعیت را به داده جدید دارند به عنوان همسایگان منتخب انتخاب میشوند.

مرحله چهارم: رأیگیری اکثریت و تصمیمگیری نهایی (Classification)
در گام پایانی، کلاسی که بیشترین سهم را در میان k همسایه منتخب دارد برنده میشود (Majority Voting):
- اگر از بین این ۳ همسایه، ۲ همسایه متعلق به کلاس B و ۱ همسایه متعلق به کلاس A باشد، اکثریت با کلاس B خواهد بود.
- بنابراین، داده جدید با اطمینان در کلاس B طبقهبندی میشود.
الگوریتم KNN در پایتون
۱. پیادهسازی پایه KNN با NumPy
در این بخش، هدف ما این است که بدون استفاده از مدل آماده، منطق داخلی الگوریتم KNN را درک کنیم.
در وهله اول، دادهها به دو متغیر مجزای X (ویژگیهای ورودی) و y (برچسب هدف) تفکیک شده و برای سازگاری با مدلهای یادگیری ماشین به آرایههای NumPy تبدیل میشوند. همچنین با استخراج ابعاد و لیست کلاسهای موجود، ساختار دادهها برای اطمینان از آمادگی جهت فرآیند آموزش اعتبارسنجی میشود.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Create a small dataset
data = pd.DataFrame({
    "Feature_1": [1.0, 1.5, 2.0, 2.3,
                  4.0, 4.5, 5.0, 5.3,
                  7.0, 7.5, 8.0, 8.3],
    "Feature_2": [1.0, 2.0, 1.5, 2.5,
                  4.0, 5.0, 4.5, 5.5,
                  7.0, 8.0, 7.5, 8.5],
    "Class":     [0, 0, 0, 0,
                  1, 1, 1, 1,
                  2, 2, 2, 2]
})
print('raw data:\n',data)#
data.info()#
data.describe()#
# Select input features and class labels
X = data[["Feature_1", "Feature_2"]].to_numpy()
y = data["Class"].to_numpy()
print('feature  2d:',X)#
print('number of samples :',X.shape[0])#

print('class 1d:',y)#
print('unique classes :', np.unique(y))#
با استفاده از کتابخانه matplotlib دادهها را بر اساس هر کلاس با رنگهای متمایز روی یک نمودار پراکندگی رسم میکند تا توزیع و مرزهای تفکیککننده بین گروهها بهصورت بصری مشخص شود. همچنین با افزودن عنوان، برچسب محورها و راهنمای نمودار، تلاش شده تا ساختار دیتاست برای تحلیل چشمی کاملاً گویا و شفاف باشد.
plt.figure(figsize=(8, 6))

colors = ['red', 'blue', 'green']
labels = ['Class 0', 'Class 1', 'Class 2']

plt.scatter(X[y == 0, 0], X[y == 0, 1], color='red',label='Class 0', s=100, edgecolors='black')
plt.scatter(X[y == 1, 0], X[y == 1, 1], color='blue',label='Class 1', s=100, edgecolors='black')
plt.scatter(X[y == 2, 0], X[y == 2, 1], color='green',label='Class 0', s=100, edgecolors='black')

'''for cls in [0, 1, 2]:
    plt.scatter(X[y == cls, 0], X[y == cls, 1],
                color=colors[cls],
                label=labels[cls],
                s=100, edgecolors='black')
'''
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.title("Visualization of 3-Class Dataset")
plt.legend()  # خیلی ساده، بدون هیچ آرگومان اضافه!
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
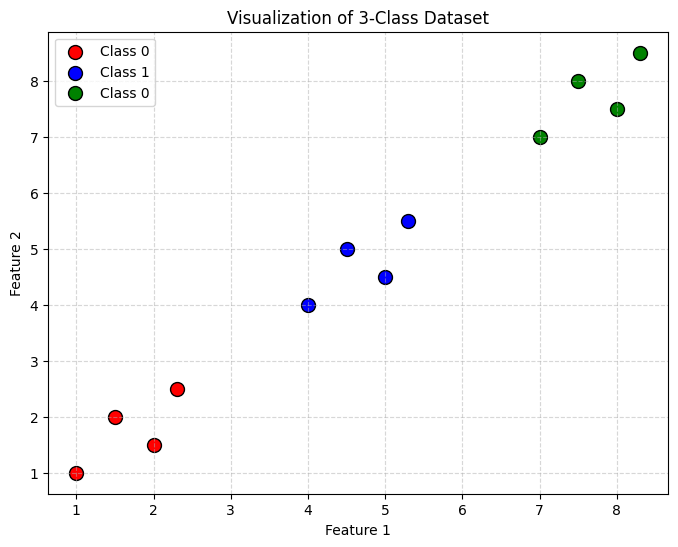
با انتخاب تصادفی تعداد مشخصی نمونه از هر کلاس، دادهها را به دو بخش آموزش و تست تقسیم میکند تا توازن کلاسها در هر دو مجموعه حفظ شود. این روش که در واقع یک «جداسازی طبقهبندی شده» (Stratified Split) است، تضمین میکند که هر کلاس در هر دو بخش حضور داشته باشد و مدل شما منصفانهتر و دقیقتر ارزیابی شود
import numpy as np
n_test_per_class = 1 # one sample for every class
test_indices = []
train_indices = []
# find classes
unique_classes = np.unique(y)
print('unique_classes',unique_classes)
for cls in unique_classes:
# find indecs of the special class
cls_indices = np.where(y == cls)[0]
print('cls_indices',cls_indices)
# shuffling indeces
#np.random.shuffle(cls_indices)
#shuffled_cls_indices = cls_indices
shuffled_cls_indices = np.random.permutation(cls_indices)
print('shuffled_cls_indices',shuffled_cls_indices)
# splitting data for test and train
test_indices.extend(shuffled_cls_indices[:n_test_per_class])
train_indices.extend(shuffled_cls_indices[n_test_per_class:])
print(test_indices)
print(train_indices)
# حالا دادهها رو تفکیک میکنیم:
X_train, X_test = X[train_indices], X[test_indices]
y_train, y_test = y[train_indices], y[test_indices]
print("تعداد هر کلاس در داده آموزش:", np.bincount(y_train))
print("تعداد هر کلاس در داده تست:", np.bincount(y_test))
ویژگیهای دادهها را با استفاده از فرمول نرمالسازی به بازه [۰، ۱] منتقل میکند و با محاسبه این مقادیر صرفاً بر اساس دادههای آموزش، از رخداد «نشت داده» (Data Leakage) در فرآیند ارزیابی مدل جلوگیری میکند.
# Find minimum and maximum values using training data only
min_values = X_train.min(axis=0)
max_values = X_train.max(axis=0)

# Scale values to the range 0 to 1
X_train_scaled = (X_train - min_values) / (max_values - min_values)
X_test_scaled = (X_test - min_values) / (max_values - min_values)

#print("X_train_scaled:", X_train_scaled)
print("X_test_scaled:\n", X_test_scaled)
برای هر نمونه تستی، ابتدا فاصله آن تا تمام دادههای آموزشی محاسبه میشود، سپس ۳ همسایه نزدیکتر انتخاب شده و کلاسی که بیشترین فراوانی یا اصطلاحاً «بیشترین رأی» را در میان این همسایگان داشته باشد، به عنوان برچسب پیشبینیشده برای آن نمونه ثبت میشود. در نهایت، با تکرار این فرآیند رأیگیری برای تمامی نمونههای داده تست و مقایسه پاسخهای مدل با برچسبهای واقعی، میزان دقت کلی الگوریتم مشخص و چاپ میشود.
# Predict the class of one sample
def knn_predict_one(sample, X_train, y_train, k):
    # Calculate the distance from the sample to every training row
    distances = np.sqrt(np.sum((X_train - sample) ** 2, axis=1))

    # Get the indexes of the k closest rows
    nearest_indexes = np.argsort(distances)[:k]

    # Get the classes of the closest rows
    nearest_classes = y_train[nearest_indexes]

    # Count the votes for each class
    votes = np.bincount(nearest_classes)

    # Return the class with the most votes
    predicted_class = np.argmax(votes)

    return predicted_class


# Choose the number of neighbors
k = 3

# Predict the class for each test sample
predictions = []

for sample in X_test_scaled:
    prediction = knn_predict_one(sample, X_train_scaled, y_train, k)
    predictions.append(prediction)

predictions = np.array(predictions)
# Calculate accuracy
accuracy = np.mean(predictions == y_test)

print("Actual classes:   ", y_test)
print("Predicted classes:", predictions)
print("Accuracy:", accuracy)
۲. الگوریتم KNN با Scikit-learn روی دیتاست Iris
دیتاست Iris یکی از معروفترین مجموعهدادههای آموزشی در یادگیری ماشین است. این دیتاست شامل ۱۵۰ نمونه گل در سه کلاس مختلف است:
- Setosa
- Versicolor
- Virginica
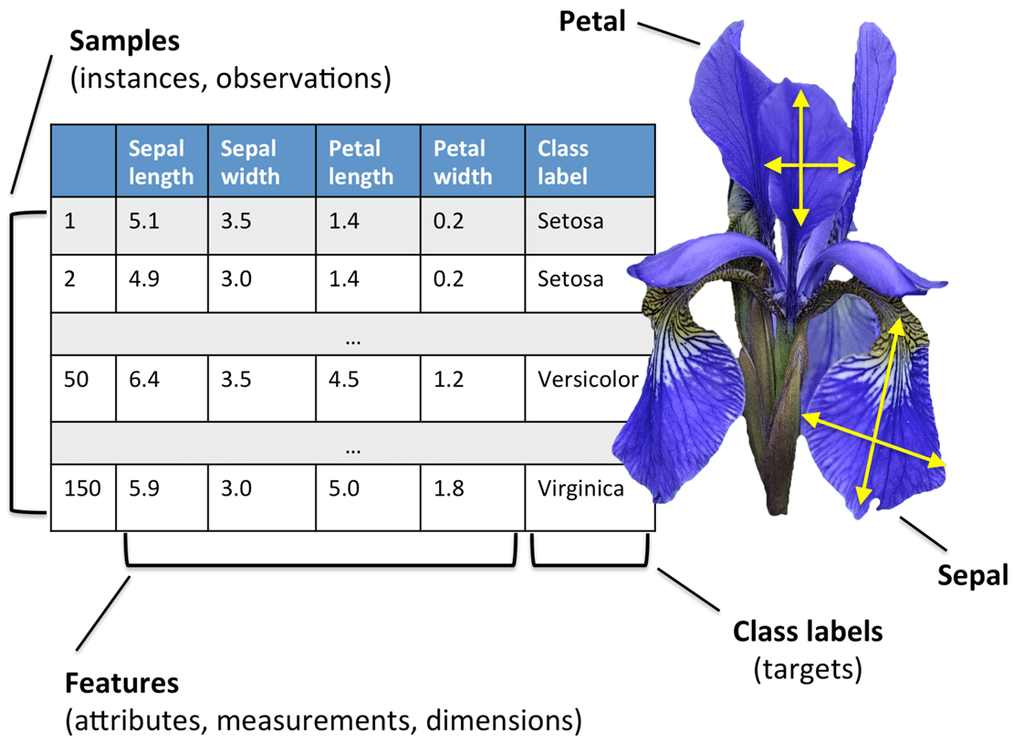
برای هر گل، چهار ویژگی اندازهگیری شده است:
- طول کاسبرگ
- عرض کاسبرگ
- طول گلبرگ
- عرض گلبرگ
کد KNN با کتابخانه Scikit-learn
۱. بارگذاری دادهها : با استفاده از load_iris() دادههای Iris را دریافت میکنیم.
۲. تقسیم دادهها: با train_test_split دادهها را به دو داده آموزش (train) و داده آزمون (test) بخش تقسیم میکنیم. استفاده از stratify=y باعث میشود نسبت کلاسها در هر دو بخش حفظ شود.
۳. نرمالسازی ویژگیها : چون KNN بر پایه فاصله کار میکند، مقیاس ویژگیها اهمیت زیادی دارد. برای همین از StandardScaler استفاده میکنیم تا ویژگیها استاندارد شوند.
۴. ساخت مدل : در اینجا مدل KNN را با n_neighbors=5 میسازیم. یعنی تصمیمگیری بر اساس ۵ همسایه نزدیکتر انجام میشود.
۵. آموزش مدل : مدل روی دادههای آموزشی آموزش داده میشود.
۶. پیشبینی: مدل کلاس نمونههای تست را پیشبینی میکند.
۷. ارزیابی: با استفاده از accuracy_score دقت مدل را محاسبه میکنیم و با classification_report معیارهای دقیقتری مثل Precision و Recall را نمایش میدهیم.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score, classification_report

# 1. Load the Iris dataset
iris = load_iris()
X, y = iris.data, iris.target

# 2. Split data into training and test sets
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3. Scale the features
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. Create the KNN model
knn = KNeighborsClassifier(n_neighbors=5)

# 5. Train the model
knn.fit(X_train_scaled, y_train)

# 6. Make predictions
y_pred = knn.predict(X_test_scaled)

# 7. Evaluate the model
accuracy = accuracy_score(y_test, y_pred)
print(f"Test Accuracy: {accuracy:.3f}")
print("\nClassification Report:")
print(classification_report(y_test, y_pred, target_names=iris.target_names))
الگوریتم KNN در متلب
برای این مثال از داده های فیشر ایریس استفاده شده است. این 4 نوع ویژگی برای 150 داده گل را در سه دسته {‘setosa’ ‘versicolor’ ‘virginica’} دسته بندی می کند. داده ها را به دو دسته آموزشی و تست دسته بندی می کنیم.
حلقه فور نوشته شده برای محاسبه فاصله هر داده تست از مجموعه داده های آموزشی می باشد. با دستور dist فاصله اقلیدسی محاسبه شده است. نتایج در نهایت با شمارش کل داده هایی که درست تشخیص داده شده اند به پایان می رسد.
load fisheriris
X = meas;
Y = cell2mat(species);
XLrn=X(1:2:150,1:4);
CLrn=Y(1:2:150,5);
XTst=X(2:2:150,1:4);
CTst=Y(2:2:150,5);
Correct=0;
for i=1:75
    d=dist(XLrn,XTst(i,:)');
    [m, Idx]=min(d);
    Cout=CLrn(Idx);
    if(Cout==CTst(i))
        Correct=Correct+1;
    end
end
دراین مثال تنها نزدیکترین همسایگی در نظر گرفته شده است. با دستور min کمترین فاصله را مشخص می کنیم. ( مقدار k برابر با یک در نظر گرفته ایم.)
انتخاب پارامتر طراحی k
برای تعیین پارامتر k برای کلاس های زوج، بهتر است از اعداد فرد انتخاب شود که از برابر شدن تعداد کلاس ها در داده ها با کمترین فاصله از داده های آموزشی اجتناب شود. بهترین انتخاب  بستگی به دادهها دارد؛ بهطور کلی، مقادیر بزرگ باعث کاهش خطا در طبقهبندی میشود، اما وضوح مرز بین کلاسها را کمتر میکند.
همانطور که اشاره شد مقدار k برابر یک نیز الگوریتم نزدیک ترین همسایه نامیده می شود.
تابع knnclassify در متلب
همانطور که در کد بالا ذکر شد شما می توانید به صورت کد نویسی برنامه ای بنویسید که دسته بندی داده ها را برای حالت k بزرگتر از یک نیز حساب کند. اما متلب کار شما را با ارائه یک فانکشن با نام fitcknn راحت می کند. به عنوان مثال برای داده های زیر می توان از تابع به این صورت استفاده نمود:
%% generate train data
n = 25; % tedad data
x1 = [ randi([1 10],[1 n]) ; randi([1 10],[1 25])];
plot (x1(1,:),x1(2,:),'r*')
x2 = [ randi([11 20],[1 n]) ; randi([1 10],[1 n])];
hold on
plot (x2(1,:),x2(2,:),'b*')

Input =  [x1,x2]';
y1 = ones(1,n);
y2 = -ones(1,n);
Target = [y1,y2];
title('train data')
%% classifier knn
k = 1
knnmodel = fitcknn(Input,Target ,'NumNeighbors',k );
در کد بالا برای یک همسایگی مورد بررسی قرار گرفته است شما می توانیدبا دادن k های بیشتر از یک نیز همسایگی های بالاتر را مورد بررسی قرار دهید. خروجی دستور اخر کلاس داده های آموزشی را برای شما مشخص خواهد کرد.
چرا در KNN نرمالسازی مهم است؟
الگوریتم KNN از فاصله بین دادهها استفاده میکند. اگر یکی از ویژگیها مقیاس بزرگتری نسبت به بقیه داشته باشد، تأثیر آن بر فاصله بیشتر میشود و ممکن است نتیجه را منحرف کند.
مثلاً اگر:
- یک ویژگی بین 1 تا 10 باشد
- و ویژگی دیگر بین 1000 تا 5000 باشد
ویژگی دوم تقریباً کل تصمیمگیری را تحت تأثیر قرار میدهد.پس استانداردسازی یا نرمالسازی در KNN معمولاً ضروری است.
انتخاب مقدار مناسب k
پارامتر k یکی از مهمترین پارامترهای این الگوریتم است:
- اگر
kخیلی کوچک باشد، مدل به نویز حساس میشود. - اگر
kخیلی بزرگ باشد، مرز بین کلاسها بیش از حد هموار میشود.
به طور معمول:
k=1→ حساستر به نویزk=3یاk=5→ انتخابهای رایج- مقادیر بزرگتر → تصمیمگیری نرمتر ولی گاهی با دقت کمتر
در مسائل دوکلاسه، معمولاً از اعداد فرد برای k استفاده میشود تا احتمال تساوی آرا کمتر شود.
جمعبندی
الگوریتم KNN یکی از سادهترین الگوریتمهای یادگیری ماشین است که منطق آن بر پایه شباهت میان دادهها قرار دارد.
در این روش، برای تعیین کلاس یک داده جدید، فاصله آن تا نمونههای آموزشی محاسبه میشود و کلاس غالب در میان نزدیکترین همسایهها انتخاب میشود.




دیدگاه (1)
خوشه بندی k_mean
[…] باشد. با توجه به توضیحات داده شده در آشنایی با الگوریتم knn (نزدیک ترین همسایه) با مفهوم محاسبه فاصله در داده های آموزشی آشنا شده […]