خوشه بندی k_mean

خوشه بندی k_mean
یکی از پر کاربرد ترین و ساده ترین الگوریتم های دسته بندی بدون نظارت (Unsupervised Learning)، خوشه بندی k- میانگین (k-mean clustering) می باشد. با توجه به توضیحات داده شده در مقاله آموزش الگوریتم knn (نزدیک ترین همسایه) با مفهوم محاسبه فاصله در داده های آموزشی آشنا شده ایم.
الگوریتم K-Means را میتوان به چشم یک مسئله بهینهسازی دید:
- کمینهسازی فاصله: اگر تابع هدف، مجموع فواصل دادهها از مراکز باشد، هدف ما کمینهسازی خطای درونخوشهای (WCSS/Inertia) است.
- بیشینهسازی شباهت: دادههایی که ویژگیهای مشابهتری دارند در یک خوشه قرار میگیرند.
در الگوریتم آموزشی kmean هدف به دست آوردن کمینه فاصله بین داده ها و شاخص (میانگین) هر گروه می باشد. مسلما در این حالت تعداد گروه ها مشخص خواهد بود.
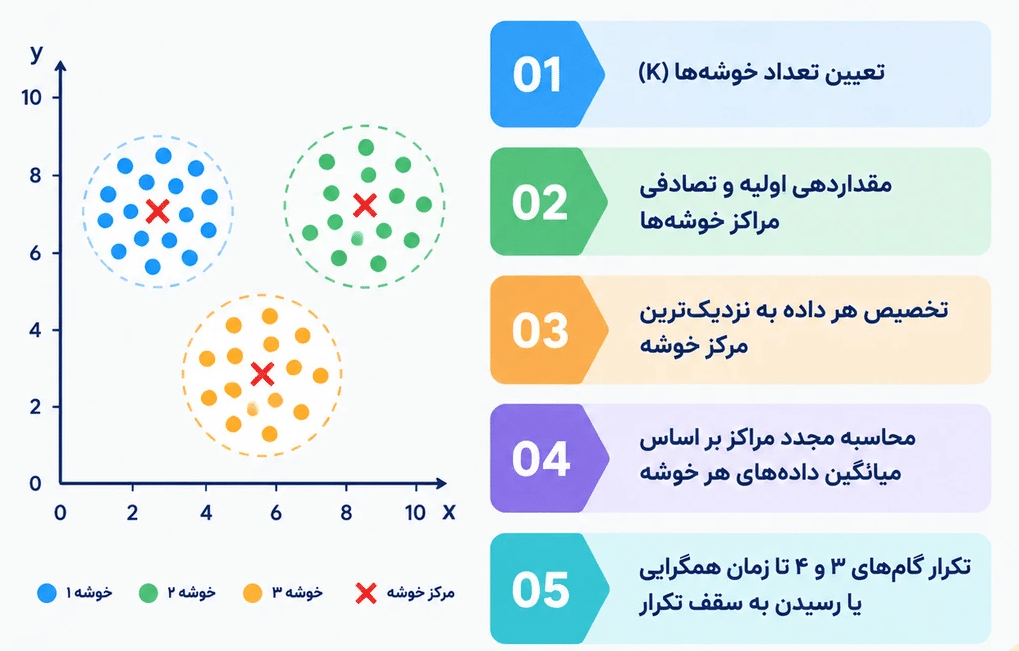
مراحل اجرای الگوریتم:

با فرض داشتن دو دسته داده (k=2) به صورت زیر مراحل زیر را دنبال می کنیم :
- k مرکز خوشه (در اینجا داده ها دو بعدی می باشد [x0,y0]) به صورت تصادفی انتخاب می کنیم. (برای این مثال دو مرکز داده به تصادف انتخاب می شود)

2. با محاسبه فاصله همه داده ها از مراکز دو خوشه، می توانیم آنها را به خوشه یک یا دو اختصاص دهیم (داده به آن خوشه ای اختصاص میابد که کمترین فاصله را از مرکز آن خوشه داشته باشد به عنوان مثال شماره یک به کلاس سبز نزدیک تر است و شماره دو به کلاس آبی تعلق می پذیرد)

3. پس از مشخص شدن کلاس هر داده بدون در نظر گرفتن مرکز خوشه قبلی، محاسبه میانگین داده های هر خوشه و تعیین مرکز خوشه جدید انجام می گیرد.

4. پس از هر بار انجام این سه مرحله باید مجموع فاصله های درون خوشه ای است محاسبه شود و با مرحله قبلی مقایسه گردد. (آشنایی با توابع فاصله دیگر اینجا مطالعه کنید)

اگر رنج تغییرات از مقدار آستانه کمتر شود یعنی عملیات خوشه بندی با دقت کافی انجام شده است. بنابراین الگوریتم خاتمه می یابد. در غیر اینصورت باید عملیات از مرحله دوم از سر گرفته شود.
5. نتیجه نهایی به صورت زیر خواهد بود. داده ها در این حالت به دو دسته متفاوت تقسیم شده اند.

پیاده سازی خوشه بندی k_mean با پایتون
در خوشهبندی K-Means هدف این است که دادههای بدون برچسب را بر اساس میزان شباهت یا فاصله هندسی در K گروه (خوشه) متمایز قرار دهیم.
۱. پیادهسازی گامبهگام
برای درک عمیق محاسبات پشت صحنه، این الگوریتم را بدون استفاده از کتابخانههای سطح بالا و صرفاً با NumPy پیادهسازی میکنیم.
گام ۱: ساخت دادههای مصنوعی
ابتدا سه خوشه با توزیع نرمال در سه موقعیت مکانی مختلف ایجاد کرده و آنها را در یک ماتریس تجمیع میکنیم:
import matplotlib.pyplot as plt
import numpy as np
# تنظیم Seed برای تکرارپذیری نتایج
np.random.seed(42)
# ساخت ۳ خوشه مجزا (هر کدام ۳۰ نقطه)
cluster1 = np.random.randn(30, 2) + [2, 2]
cluster2 = np.random.randn(30, 2) + [7, 7]
cluster3 = np.random.randn(30, 2) + [2, 8]
# ترکیب خوشهها در یک دیتاست واحد (مجموعاً ۹۰ نمونه)
X = np.vstack([cluster1, cluster2, cluster3])
print("Dataset shape:", X.shape)
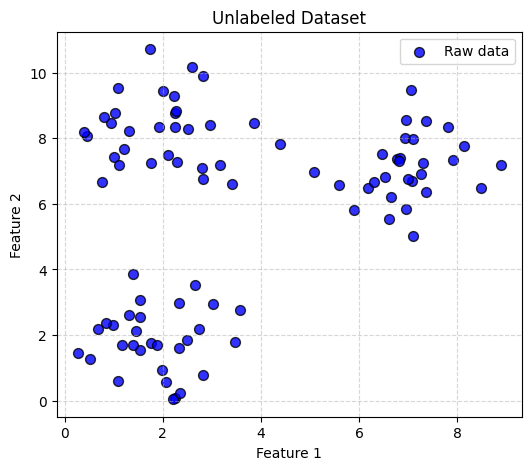
گام ۲: مصورسازی دادههای خام
پیش از اجرای الگوریتم، دادههای بدون برچسب را رسم میکنیم تا توزیع اولیه آنها را ببینیم:
# رسم دادههای خام و بدون برچسب
plt.figure(figsize=(6, 5))
plt.scatter(
X[:, 0],
X[:, 1],
color="b",
edgecolors="black",
s=50,
alpha=0.8,
label="Raw data",
)
plt.title("Unlabeled Dataset")
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.legend()
plt.grid(True, linestyle="--", alpha=0.5)
plt.show()
گام ۳: پیادهسازی تابع هسته ریاضی K-Means
تابع زیر دقیقاً مراحل تخصیص فاصله اقلیدسی (np.linalg.norm) و بهروزرسانی میانگین (mean(axis=0)) را انجام میدهد:
def simple_kmeans(X, k=3, max_iters=10):
# ۱. انتخاب تصادفی k نقطه از دادهها به عنوان مراکز اولیه
random_indices = np.random.choice(len(X), size=k, replace=False)
centroids = X[random_indices]
# حلقه تکرار بهینهسازی
for step in range(max_iters):
# ۲. تخصیص هر نمونه به نزدیکترین مرکز
labels = []
for point in X:
distances = [np.linalg.norm(point - c) for c in centroids]
closest_center = np.argmin(distances)
labels.append(closest_center)
labels = np.array(labels)
# ۳. بهروزرسانی مراکز با میانگینگیری از اعضای هر خوشه
for i in range(k):
points_in_cluster = X[labels == i]
if len(points_in_cluster) > 0:
centroids[i] = points_in_cluster.mean(axis=0)
return centroids, labels
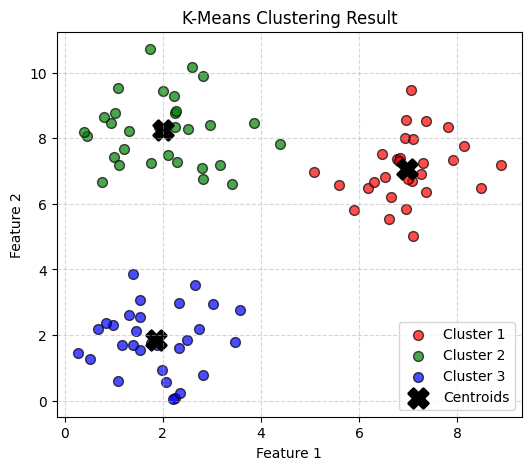
گام ۴: آموزش و نمایش نتایج خوشهبندی پایه
حال الگوریتم را روی دادهها اجرا کرده و خوشههای رنگی و موقعیت نهایی مراکز (با علامت ضربدر) را نمایش میدهیم:
# اجرای الگوریتم دستی
k = 3
centroids, labels = simple_kmeans(X, k=k, max_iters=10)
# رسم نتیجه نهایی خوشهبندی
plt.figure(figsize=(6, 5))
colors = ["red", "green", "blue"]
for i in range(k):
plt.scatter(
X[labels == i, 0],
X[labels == i, 1],
c=colors[i],
label=f"Cluster {i+1}",
alpha=0.7,
edgecolors="black",
s=50,
)
# رسم مراکز نهایی خوشهها
plt.scatter(
centroids[:, 0],
centroids[:, 1],
c="black",
marker="X",
s=200,
linewidths=2,
label="Centroids",
)
plt.title("K-Means Clustering Result (NumPy Implementation)")
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.legend()
plt.grid(True, linestyle="--", alpha=0.5)
plt.show()
۲. پیادهسازی با کتابخانه Scikit-Learn
در کاربردهای واقعی، از کلاس بهینهشده KMeans در کتابخانه sklearn.cluster استفاده میکنیم که از الگوریتم پیشرفته k-means++ برای مقداردهی اولیه و پردازش موازی سریع بهره میبرد.
بخش ۱: بارگذاری و آمادهسازی دیتاست بنچمارک Iris
دیتاست مشهور گل زنبق (Iris) دارای ۱۵۰ نمونه در ۳ گونه طبیعی است. برای سادگی مصورسازی، دو ویژگی اول (طول و عرض کاسبرگ) را استخراج میکنیم:
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris

# بارگذاری دیتاست Iris
iris = load_iris()

# انتخاب دو ویژگی اول برای مصورسازی دوبعدی
X = iris.data[:, :2]

print("Dataset shape:", X.shape)
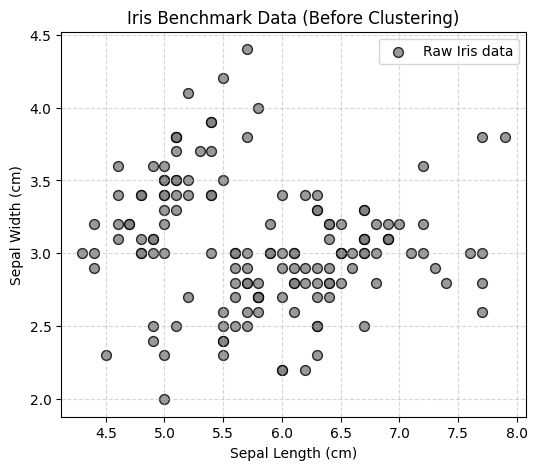
بخش ۲: رسم دادههای خام بنچمارک
پیش از اعمال مدل، دادهها را بدون برچسب نمایش میدهیم تا چالش همپوشانی نقاط را مشاهده کنیم:
plt.figure(figsize=(6, 5))
plt.scatter(
    X[:, 0],
    X[:, 1],
    color="gray",
    edgecolors="black",
    s=50,
    alpha=0.8,
    label="Raw Iris data",
)

plt.title("Iris Benchmark Data (Before Clustering)")
plt.xlabel("Sepal Length (cm)")
plt.ylabel("Sepal Width (cm)")
plt.legend()
plt.grid(True, linestyle="--", alpha=0.5)
plt.show()
بخش ۳: ساخت مدل، آموزش و استخراج پارامترها
در این مرحله مدل را تعریف کرده و با متد .fit() آموزش میدهیم:
from sklearn.cluster import KMeans
# ۱. تعریف مدل با ۳ خوشه و ۱۰ بار اجرای تصادفی برای یافتن بهترین اینرسی
kmeans = KMeans(n_clusters=3, random_state=42, n_init=10)
# ۲. برازش مدل بر روی دادهها
kmeans.fit(X)
# ۳. استخراج برچسبهای پیشبینیشده و مختصات مراکز نهایی
labels = kmeans.labels_
centroids = kmeans.cluster_centers_
print("Final Centroids:\n", centroids)
توضیح هایپرپارامترهای کلیدی:
n_clusters: تعداد خوشههای هدف (k=3).n_init=10: تعداد دفعاتی که الگوریتم با مقداردهیهای اولیه مختلف اجرا میشود تا بهترین نتیجه (کمترین اینرسی) انتخاب گردد.random_state: تثبیت تصادفیسازی جهت تکرارپذیری آزمایش.
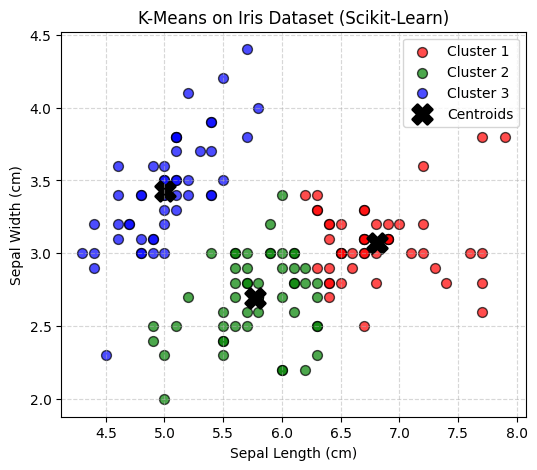
بخش ۴: مصورسازی نتایج مدل Scikit-Learn
در نهایت، گروهبندی انجامشده توسط Scikit-Learn را به همراه مراکز خوشهها ترسیم میکنیم:
plt.figure(figsize=(6, 5))
colors = ["red", "green", "blue"]
# رسم نقاط هر خوشه
for i in range(3):
plt.scatter(
X[labels == i, 0],
X[labels == i, 1],
c=colors[i],
label=f"Cluster {i+1}",
alpha=0.7,
edgecolors="black",
s=50,
)
# رسم مراکز محاسبهشده توسط Scikit-Learn
plt.scatter(
centroids[:, 0],
centroids[:, 1],
c="black",
marker="X",
s=200,
linewidths=2,
label="Centroids",
)
plt.title("K-Means on Iris Dataset (Scikit-Learn)")
plt.xlabel("Sepal Length (cm)")
plt.ylabel("Sepal Width (cm)")
plt.legend()
plt.grid(True, linestyle="--", alpha=0.5)
plt.show()
پیاده سازی خوشه بندی k_mean با متلب
با توجه به تئوری توضیح داده شد، می توانید با حلقه تکرار for و if این الگوریتم را پیاده سازی کنید. (کد متلب پایه موجود می باشد) اما در متلب توابع از پیش تعریف شده ای وجود دارد که به راحتی می تواند کار کد نویسی شما را ساده تر کند.
به مثال زیر توجه کنید:
X = [randn(100,2)*0.75+ones(100,2);
    randn(100,2)*0.5-ones(100,2);
    randn(100,2)*0.75];
برای تولید سه دسته داده تست با واریانس و میانگین متفات از الگوی sigma*randn()+mean استفاده شده است. هر ستون ماتریس x بیانگر یک دسته داده می باشد.
[idx,C] = kmeans(X,3);
با استفاده از دستور kmean الگوریتم را برای 3 دسته داده اجرا می کنیم.برای رسم نتایج از کد های زیر استفاده شده است.
figure
gscatter(X(:,1),X(:,2),idx,'bgm')
hold on
plot(C(:,1),C(:,2),'kx')
legend('Cluster 1','Cluster 2','Cluster 3','Cluster Centroid')
داده ها و مراکز داده در شکل زیر پس از اعمال الگوریتم k_mean نشان داده شده است.

مزایا و معایب الگوریتم K-Means
برای جمع بندی مزایا و معایب الگوریتم به جدول زیر مراجعه کنید.
| مزایا | معایب |
|---|---|
| ساده و سریع: پیادهسازی آسان و پیچیدگی محاسباتی خطی مناسب برای دیتاستهای حجیم. | نیاز به تعیین K: تعداد خوشهها باید از ابتدا معین باشد (نیاز به تحلیلهایی مثل Elbow یا Silhouette). |
| مقیاسپذیر: توانایی پردازش روان دادههای بزرگ با ابعاد متوسط. | حساس به مقداردهی اولیه: امکان گیر افتادن در مینیممهای محلی (بهبود با k-means++). |
| تفسیرپذیری بالا: خوشهها بر اساس فاصله از یک نقطه مرکزی (میانگین) به راحتی قابل درک هستند. | حساسیت به دادههای پرت (Outliers): دادههای پرت میانگین خوشه را به شدت منحرف میکنند. |
| عملکرد عالی روی دادههای کروی: ایدهآل برای دادههایی با توزیع همگن و اشکال دایرهای/کروی. | نامناسب برای اشکال پیچیده: عدم کارایی در تفکیک خوشههای غیرخطی، نواری یا با چگالیهای متفاوت. |